Creating noise from data is easy; creating data from noise is generative modeling.
Song et al., Score-Based Generative Modeling through Stochastic Differential Equations (2021)
6장에서 우리는 Score Function $\nabla_x \log p(x)$를 학습하는 것이 생성 모델링의 강력한 접근법임을 보았고, DDPM의 노이즈 예측과 Score 예측이 $\epsilon_\theta = -\sqrt{1-\bar{\alpha}_t} \cdot s_\theta$의 관계로 수학적으로 등가임을 확인했습니다. 그런데 지금까지 우리가 다룬 모든 프레임워크 (DDPM의 마르코프 체인, NCSN의 다중 노이즈 레벨) 는 본질적으로 이산 시간(discrete time) 위에서 정의되어 있었습니다. 즉 $t = 0, 1, 2, \ldots, T$라는 유한한 정수 단계를 따라 노이즈가 더해지고 제거되었습니다.
이번 장에서는 이 이산 시간 프레임워크를 연속 시간(continuous time)으로 확장합니다. 단계의 수를 무한히 늘려 $\Delta t \to 0$의 극한을 취하면, Diffusion Process는 확률 미분 방정식(Stochastic Differential Equation, SDE)으로 기술되는 연속적인 궤적이 됩니다. 이 관점은 Song et al.이 2021년에 제시한 것으로, 그때까지 별개로 발전해 온 DDPM과 Score-based 모델을 하나의 통합된 수학적 언어 안에서 바라볼 수 있게 해주었습니다. 나아가 우리는 이 확률적 과정과 동일한 주변 분포를 갖는 결정론적 상미분 방정식(Probability Flow ODE)을 도입하여, 빠른 샘플링과 정확한 가능도 계산의 이론적 기초를 마련할 것입니다.
7.1 이산에서 연속으로: 왜 연속 시간인가
7.1.1 이산 시간 프레임워크의 한계
4장과 5장에서 본 DDPM은 $T$개의 이산 단계를 따라 진행되었습니다. 이 $T$라는 숫자는 본질적으로 설계를 위한 선택이며, 학습된 모델은 특정한 $T$와 노이즈 스케줄 $\{\beta_t\}_{t=1}^{T}$에 묶여 있습니다. 이로부터 몇 가지 근본적인 질문이 생깁니다.
첫째, $T$는 얼마여야 하는가? DDPM은 일반적으로 $T = 1000$을 사용하는데, 이 값이 너무 작으면 가우시안 근사가 깨지고, 너무 크면 샘플링이 느려집니다.
둘째, 학습 시의 $T$와 다른 단계 수로 샘플링할 수 있는가? 이산 프레임워크에서는 이것이 자명하지 않습니다.
셋째, DDPM과 NCSN은 겉보기에 매우 다른 알고리즘인데, 이들이 정말 본질적으로 다른 것인가, 아니면 같은 무언가의 다른 표현인가?
이러한 질문들에 대한 통합적인 답을 주는 것이 바로 연속 시간 관점입니다.
7.1.2 단계 수를 무한대로: 연속 극한
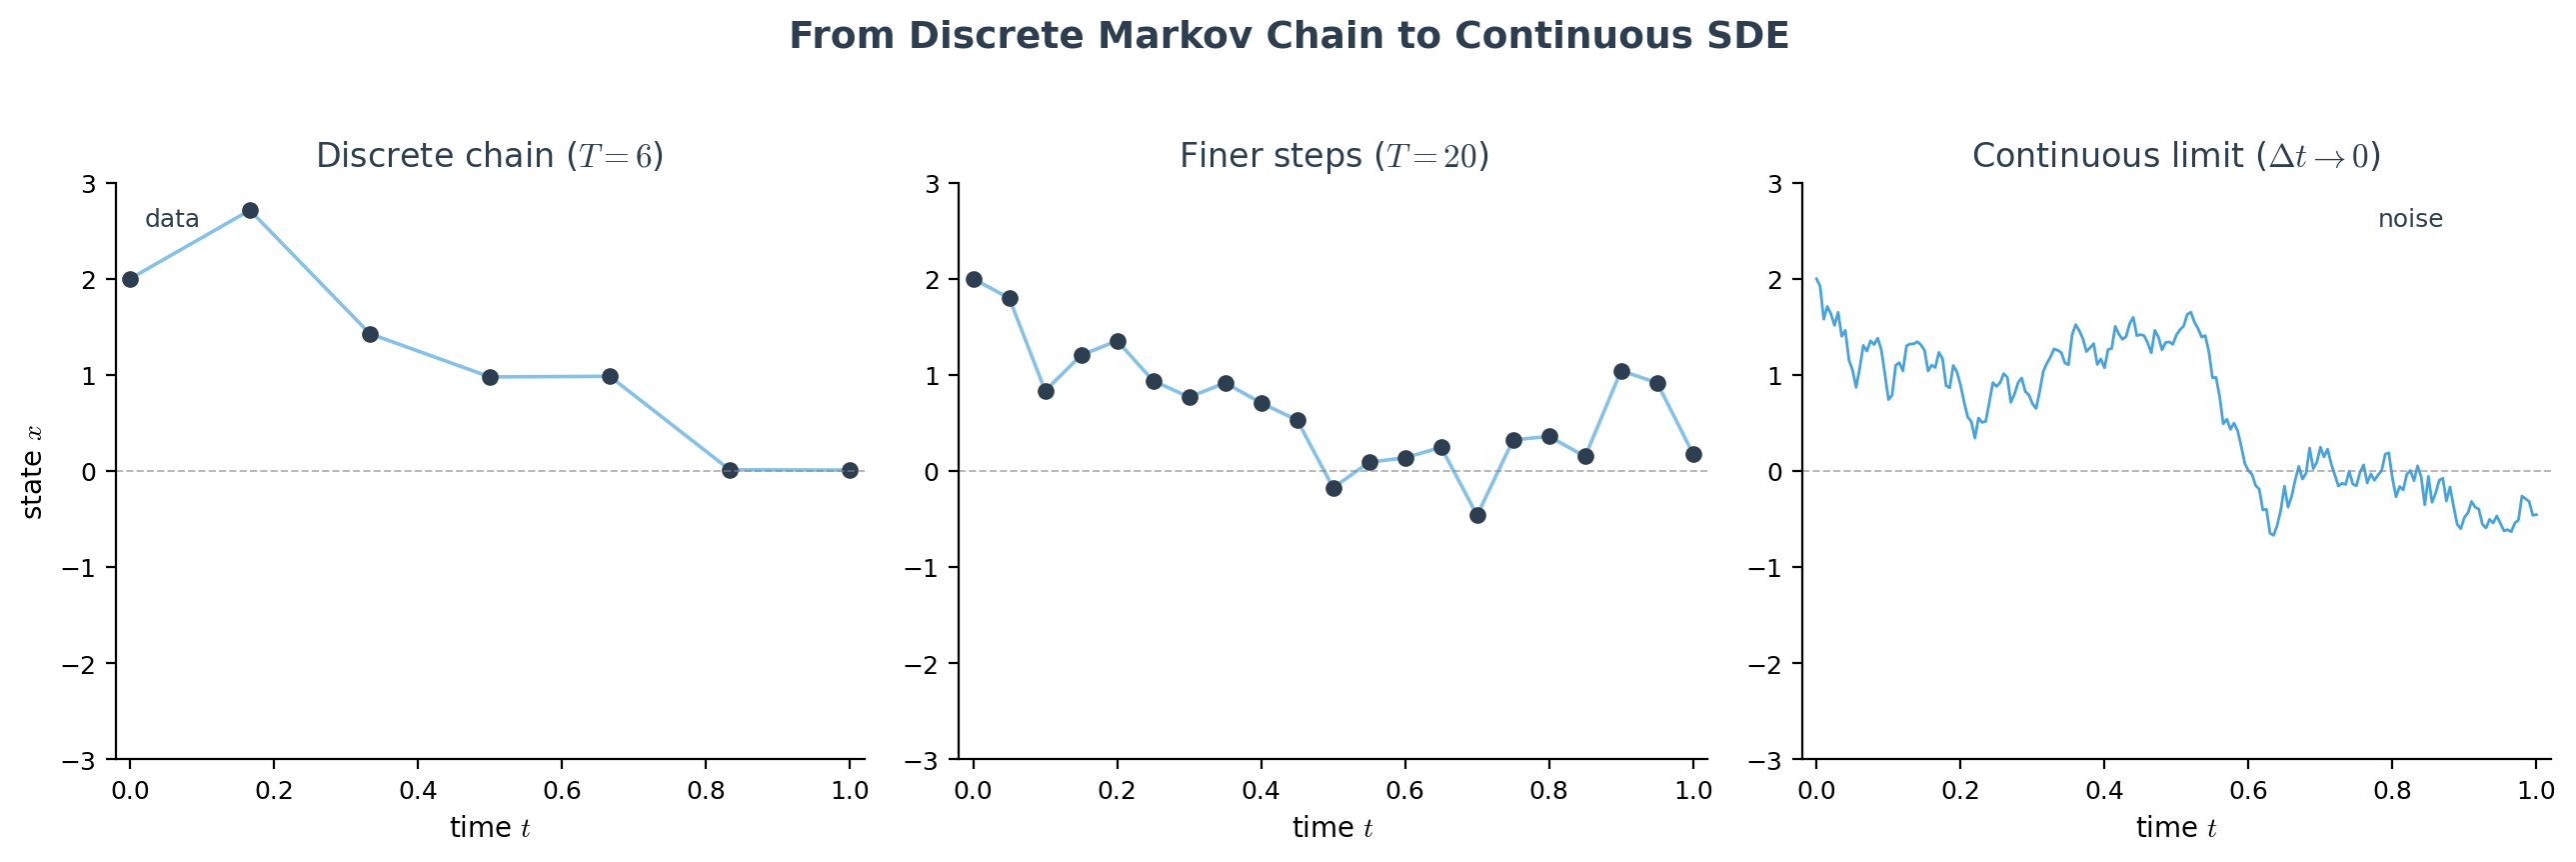
핵심 아이디어는 단순합니다. 이산 시간 $t \in \{0, 1, \ldots, T\}$를 정규화하여 연속 변수 $t \in [0, 1]$로 다시 매개변수화하고, 단계의 수를 무한히 늘려 각 단계의 시간 간격 $\Delta t = 1/T$를 0으로 보내는 것입니다. DDPM의 한 단계 갱신을 다시 살펴봅시다.
$$ x_t = \sqrt{1 - \beta_t}\, x_{t-1} + \sqrt{\beta_t}\, z, \quad z \sim \mathcal{N}(0, \mathbf{I}) $$
이제 노이즈 스케줄을 연속 함수 $\beta(t)$로 보고 $\beta_t = \beta(t)\,\Delta t$로 두겠습니다. $\beta_t$가 작을 때 $\sqrt{1-\beta_t} \approx 1 - \frac{1}{2}\beta_t$이므로, 위 식은 다음과 같이 근사됩니다.
$$ x_t \approx x_{t-1} - \frac{1}{2}\beta(t)\,\Delta t\, x_{t-1} + \sqrt{\beta(t)\,\Delta t}\, z $$
양변에서 $x_{t-1}$을 빼면, 상태의 변화량 $\Delta x = x_t - x_{t-1}$이 다음과 같이 표현됩니다.
$$ \Delta x \approx -\frac{1}{2}\beta(t)\, x\, \Delta t + \sqrt{\beta(t)}\, \sqrt{\Delta t}\, z $$
여기서 $\Delta t \to 0$의 극한을 취하면, 결정론적 변화를 나타내는 $\Delta t$ 항과 확률적 변화를 나타내는 $\sqrt{\Delta t}\, z$ 항이 각각 무한소 $dt$와 위너 과정의 증분 $dw$로 수렴합니다. 그 결과 다음과 같은 확률 미분 방정식을 얻습니다.
$$ dx = -\frac{1}{2}\beta(t)\, x\, dt + \sqrt{\beta(t)}\, dw $$
이것이 바로 DDPM의 연속 시간 극한이며, 뒤에서 다룰 VP-SDE(Variance Preserving SDE)입니다. 확률적 항이 $\Delta t$가 아니라 $\sqrt{\Delta t}$로 스케일링된다는 점에 주목하시기 바랍니다. 이는 브라운 운동의 본질적 특성으로, 다음 절에서 그 의미를 자세히 살펴봅니다.
7.1.3 통합의 약속
연속 시간 관점이 제공하는 것은 단순한 수학적 우아함이 아닙니다. 이 프레임워크 안에서 DDPM과 NCSN은 동일한 일반 SDE의 서로 다른 특수한 경우로 드러나며, 어떤 단계 수로 학습했든 샘플링 시에는 임의의 수치 해법(numerical solver)을 자유롭게 선택할 수 있게 됩니다. 또한 모든 Diffusion Process에 대해 동일한 주변 분포를 공유하는 결정론적 ODE가 존재함이 밝혀지는데, 이것이 가능도 계산과 빠른 샘플링의 문을 엽니다.
7.2 확률 미분 방정식의 기초
7.2.1 브라운 운동과 위너 과정
SDE를 이해하려면 먼저 그 확률적 핵심인 위너 과정(Wiener process) $w(t)$, 즉 수학적으로 정식화된 브라운 운동을 알아야 합니다. 위너 과정은 다음 성질을 만족하는 연속 확률 과정입니다.
첫째, $w(0) = 0$에서 출발합니다. 둘째, 증분이 독립입니다. 즉 겹치지 않는 시간 구간에서의 변화량들은 서로 독립입니다. 셋째, 시간 $s$에서 $t$까지의 증분이 가우시안을 따릅니다.
$$ w(t) - w(s) \sim \mathcal{N}(0, (t-s)\mathbf{I}), \quad t > s $$
이 세 번째 성질이 결정적으로 중요합니다. 증분의 분산이 시간 간격에 비례하므로, 표준편차는 시간 간격의 제곱근에 비례합니다. 따라서 무한소 증분은 $dw \sim \mathcal{N}(0, dt\,\mathbf{I})$이며, 형식적으로 $dw \sim \sqrt{dt}\,\mathcal{N}(0, \mathbf{I})$로 쓸 수 있습니다. 앞 절에서 확률 항이 $\sqrt{\Delta t}$로 스케일링되었던 이유가 바로 이것입니다.
7.2.2 SDE의 일반 형태
이제 일반적인 SDE를 정의할 수 있습니다. 상태 $x(t) \in \mathbb{R}^d$의 시간 변화는 다음과 같이 기술됩니다.
$$ dx = f(x, t)\, dt + g(t)\, dw $$
여기서 두 항은 각각 명확한 물리적 의미를 가집니다. $f(x, t)$는 drift 계수(drift coefficient)로, 상태를 특정 방향으로 끌어당기는 결정론적 흐름을 나타냅니다. $g(t)$는 diffusion 계수(diffusion coefficient)로, 무작위 요동의 크기를 조절합니다. drift가 시스템의 평균적 경향을 결정한다면, diffusion은 그 주위의 불확실성을 퍼뜨립니다.
일반적으로 diffusion 계수는 상태 $x$에 의존할 수도 있지만, Diffusion 생성 모델에서는 분석을 단순화하기 위해 $g$가 시간 $t$에만 의존하는 형태를 주로 사용합니다.
7.2.3 Itô 적분에 대한 직관
SDE $dx = f\,dt + g\,dw$는 형식적인 표기이며, 그 엄밀한 의미는 적분 형태에서 드러납니다.
$$ x(t) = x(0) + \int_0^t f(x(s), s)\, ds + \int_0^t g(s)\, dw(s) $$
두 번째 항은 위너 과정에 대한 적분으로, Itô 적분(Itô integral)이라 불립니다. 위너 과정이 미분 불가능하다는 사실 때문에, 이 적분은 일반적인 리만 적분과는 다른 방식으로 정의되어야 합니다. Itô 적분은 적분 구간을 나눌 때 각 소구간의 왼쪽 끝점에서 피적분 함수를 평가한다는 규약을 따르며, 이로부터 일반 미적분과 다른 연쇄 법칙 (Itô의 보조정리(Itô's lemma))이 따라 나옵니다. 본 장에서는 SDE를 다루는 데 필요한 직관에 집중하므로 Itô 미적분의 기술적 세부는 깊이 들어가지 않지만, 뒤에서 Reverse SDE와 Probability Flow ODE를 도출할 때 그 결과를 사용하게 됩니다.
7.3 Forward Process를 SDE로
7.3.1 Forward SDE의 일반 형태
이제 Diffusion의 Forward Process를 SDE로 기술합니다. 데이터 분포 $p_0 = p_{\text{data}}$에서 출발하여 시간이 흐를수록 점점 더 많은 노이즈가 주입되고, 최종 시각 $t = T$(연속 매개변수화에서는 흔히 $T = 1$)에서 다루기 쉬운 사전 분포 $p_T$(일반적으로 표준 가우시안)에 도달하는 과정입니다. 이 과정은 다음 SDE로 표현됩니다.
$$ dx = f(x, t)\, dt + g(t)\, dw $$
서로 다른 $f$와 $g$의 선택은 서로 다른 Diffusion 모델에 대응합니다. Song et al.(2021)은 두 가지 대표적인 형태를 제시했으며, 이들은 각각 DDPM과 NCSN의 연속 극한입니다.
7.3.2 VP-SDE: DDPM의 연속 극한
7.1절에서 유도한 대로, DDPM의 연속 극한은 다음 SDE입니다.
$$ dx = -\frac{1}{2}\beta(t)\, x\, dt + \sqrt{\beta(t)}\, dw $$
이를 VP-SDE(Variance Preserving SDE), 즉 분산 보존 SDE라 부릅니다. 이름이 가리키듯, 이 과정은 입력 데이터가 적절히 정규화되어 있을 때 과정 전체에 걸쳐 분산을 유한하게 유지합니다. drift 항 $-\frac{1}{2}\beta(t)x$는 상태를 원점으로 끌어당기고, diffusion 항 $\sqrt{\beta(t)}$는 노이즈를 주입합니다. 이 두 효과가 균형을 이루어, $t \to T$에서 분포가 표준 가우시안 $\mathcal{N}(0, \mathbf{I})$로 수렴합니다.
7.3.3 VE-SDE: NCSN/SMLD의 연속 극한
한편 6장에서 다룬 NCSN(Song & Ermon, 2019)은 데이터에 점점 큰 분산의 노이즈를 더하는 방식이었습니다. 이를 연속 극한으로 보내면, drift가 없고 diffusion만 시간에 따라 커지는 SDE가 됩니다.
$$ dx = \sqrt{\frac{d[\sigma^2(t)]}{dt}}\, dw $$
이를 VE-SDE(Variance Exploding SDE), 즉 분산 폭발 SDE라 부릅니다. 여기서는 drift 항 $f(x,t) = 0$이며, 시간이 흐를수록 노이즈 분산 $\sigma^2(t)$가 매우 큰 값으로 발산합니다. 따라서 VE-SDE의 사전 분포는 분산이 큰 가우시안이며, 데이터의 스케일이 이 큰 분산에 압도되어 사실상 무시할 수 있게 됩니다.
Song et al.(2021)은 이 둘을 보간하는 sub-VP SDE도 제안했는데, 이는 특히 가능도 측면에서 우수한 성능을 보였습니다. 세 가지 형태의 차이를 정리하면 다음과 같습니다.
| SDE 종류 | drift $f(x,t)$ | 대응하는 이산 모델 | 사전 분포 |
|---|---|---|---|
| VP-SDE | $-\frac{1}{2}\beta(t)x$ | DDPM (Ho et al., 2020) | $\mathcal{N}(0, \mathbf{I})$ |
| VE-SDE | $0$ | SMLD/NCSN (Song & Ermon, 2019) | $\mathcal{N}(0, \sigma_{\max}^2 \mathbf{I})$ |
| sub-VP SDE | $-\frac{1}{2}\beta(t)x$ | (Song et al., 2021 신규 제안) | $\mathcal{N}(0, \mathbf{I})$ |
7.4 Reverse-time SDE: 시간을 거슬러 오르다
7.4.1 시간 역전의 문제
Forward SDE는 데이터를 노이즈로 변환합니다. 생성을 위해서는 이 과정을 거꾸로 돌려 노이즈에서 데이터로 향하는 길을 찾아야 합니다. 2장에서 직관적으로 다루었던 이 "역방향 여정"이, 연속 시간에서는 놀랍도록 우아한 형태를 가집니다.
결정론적 ODE라면 시간을 거꾸로 돌리는 일은 단지 부호를 바꾸는 것에 불과합니다. 그러나 SDE에는 무작위성이 있기 때문에, 시간 역전이 또 다른 잘 정의된 확산 과정이 된다는 보장이 전혀 자명하지 않습니다. 이 비자명한 사실을 확립한 것이 Anderson(1982)의 정리입니다.
7.4.2 Anderson의 정리
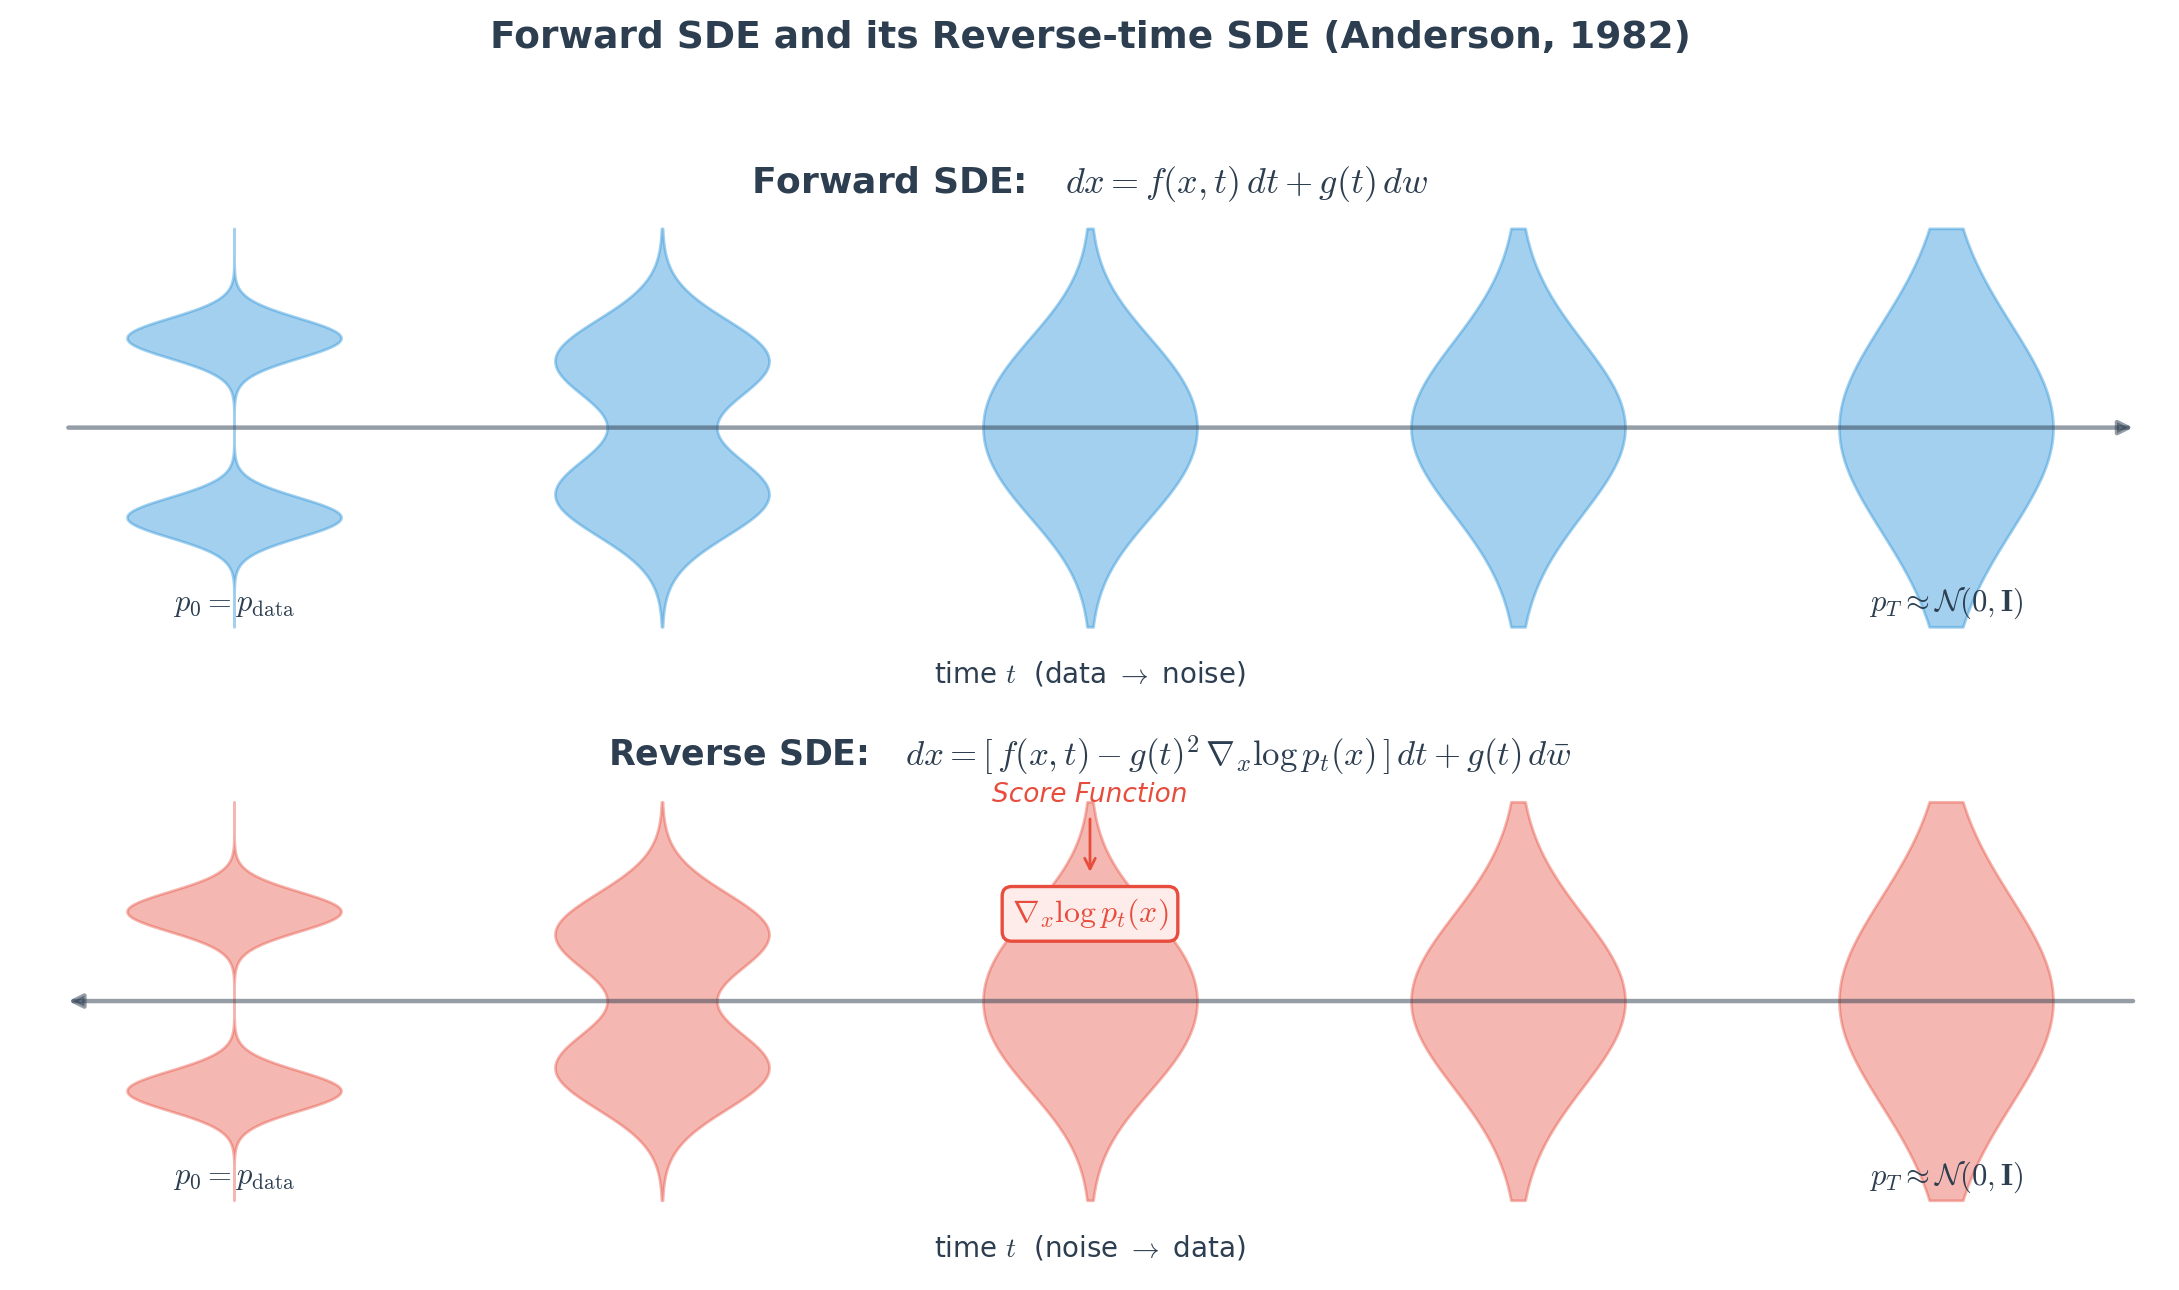
Anderson(1982)은 순방향 확산 과정의 시간 역전이 또 하나의 확산 과정이며, 그것이 만족하는 SDE를 명시적으로 제시했습니다. Forward SDE가 $dx = f(x,t)\,dt + g(t)\,dw$일 때, 이에 대응하는 Reverse-time SDE는 다음과 같습니다.
$$ dx = \left[ f(x, t) - g(t)^2 \nabla_x \log p_t(x) \right] dt + g(t)\, d\bar{w} $$
여기서 $p_t(x)$는 시각 $t$에서의 주변 분포(marginal distribution)이고, $\bar{w}$는 시간을 거꾸로 흐르게 한 위너 과정이며, $dt$는 음의 시간 증분입니다. 이 방정식을 $t = T$에서 $t = 0$ 방향으로 풀면, 사전 분포 $p_T$의 샘플이 점차 데이터 분포 $p_0$의 샘플로 변환됩니다.
7.4.3 Score Function이 모든 것의 열쇠
Reverse-time SDE의 식을 자세히 보면, 알려지지 않은 항은 오직 하나 $\nabla_x \log p_t(x)$, 즉 시각 $t$에서의 Score Function뿐입니다. drift $f$와 diffusion $g$는 우리가 Forward Process를 정의할 때 이미 정한 것이므로 알고 있습니다. 따라서 각 시각의 Score만 알면 Reverse-time SDE를 완전히 결정할 수 있고, 생성이 가능해집니다.
그렇다면 이 시간 의존적 Score를 어떻게 추정할까요? 6장에서 본 Denoising Score Matching을 모든 시각 $t$에 대해 동시에 적용하면 됩니다. 신경망 $s_\theta(x, t)$가 각 시각의 Score를 근사하도록, 다음과 같은 시간 가중 목적함수를 최소화합니다.
$$ \mathcal{L} = \mathbb{E}_{t}\left\{ \lambda(t)\, \mathbb{E}_{x_0}\, \mathbb{E}_{x_t \mid x_0}\left[ \left\| s_\theta(x_t, t) - \nabla_{x_t} \log p_{0t}(x_t \mid x_0) \right\|^2 \right] \right\} $$
여기서 $\lambda(t)$는 시각별 가중치, $p_{0t}(x_t \mid x_0)$는 Forward SDE에 의해 결정되는 전이 분포(transition kernel)입니다. VP-SDE와 VE-SDE 모두 이 전이 분포가 가우시안이므로, 그 Score는 닫힌 형태로 계산되어 학습 목표가 명시적으로 주어집니다. 이는 5장에서 본 DDPM의 단순화된 손실, 그리고 6장에서 본 NCSN의 다중 노이즈 목적함수를 연속 시간으로 통합한 것에 정확히 대응합니다.
7.5 Probability Flow ODE: 결정론적 쌍둥이
7.5.1 동일한 주변 분포, 다른 궤적
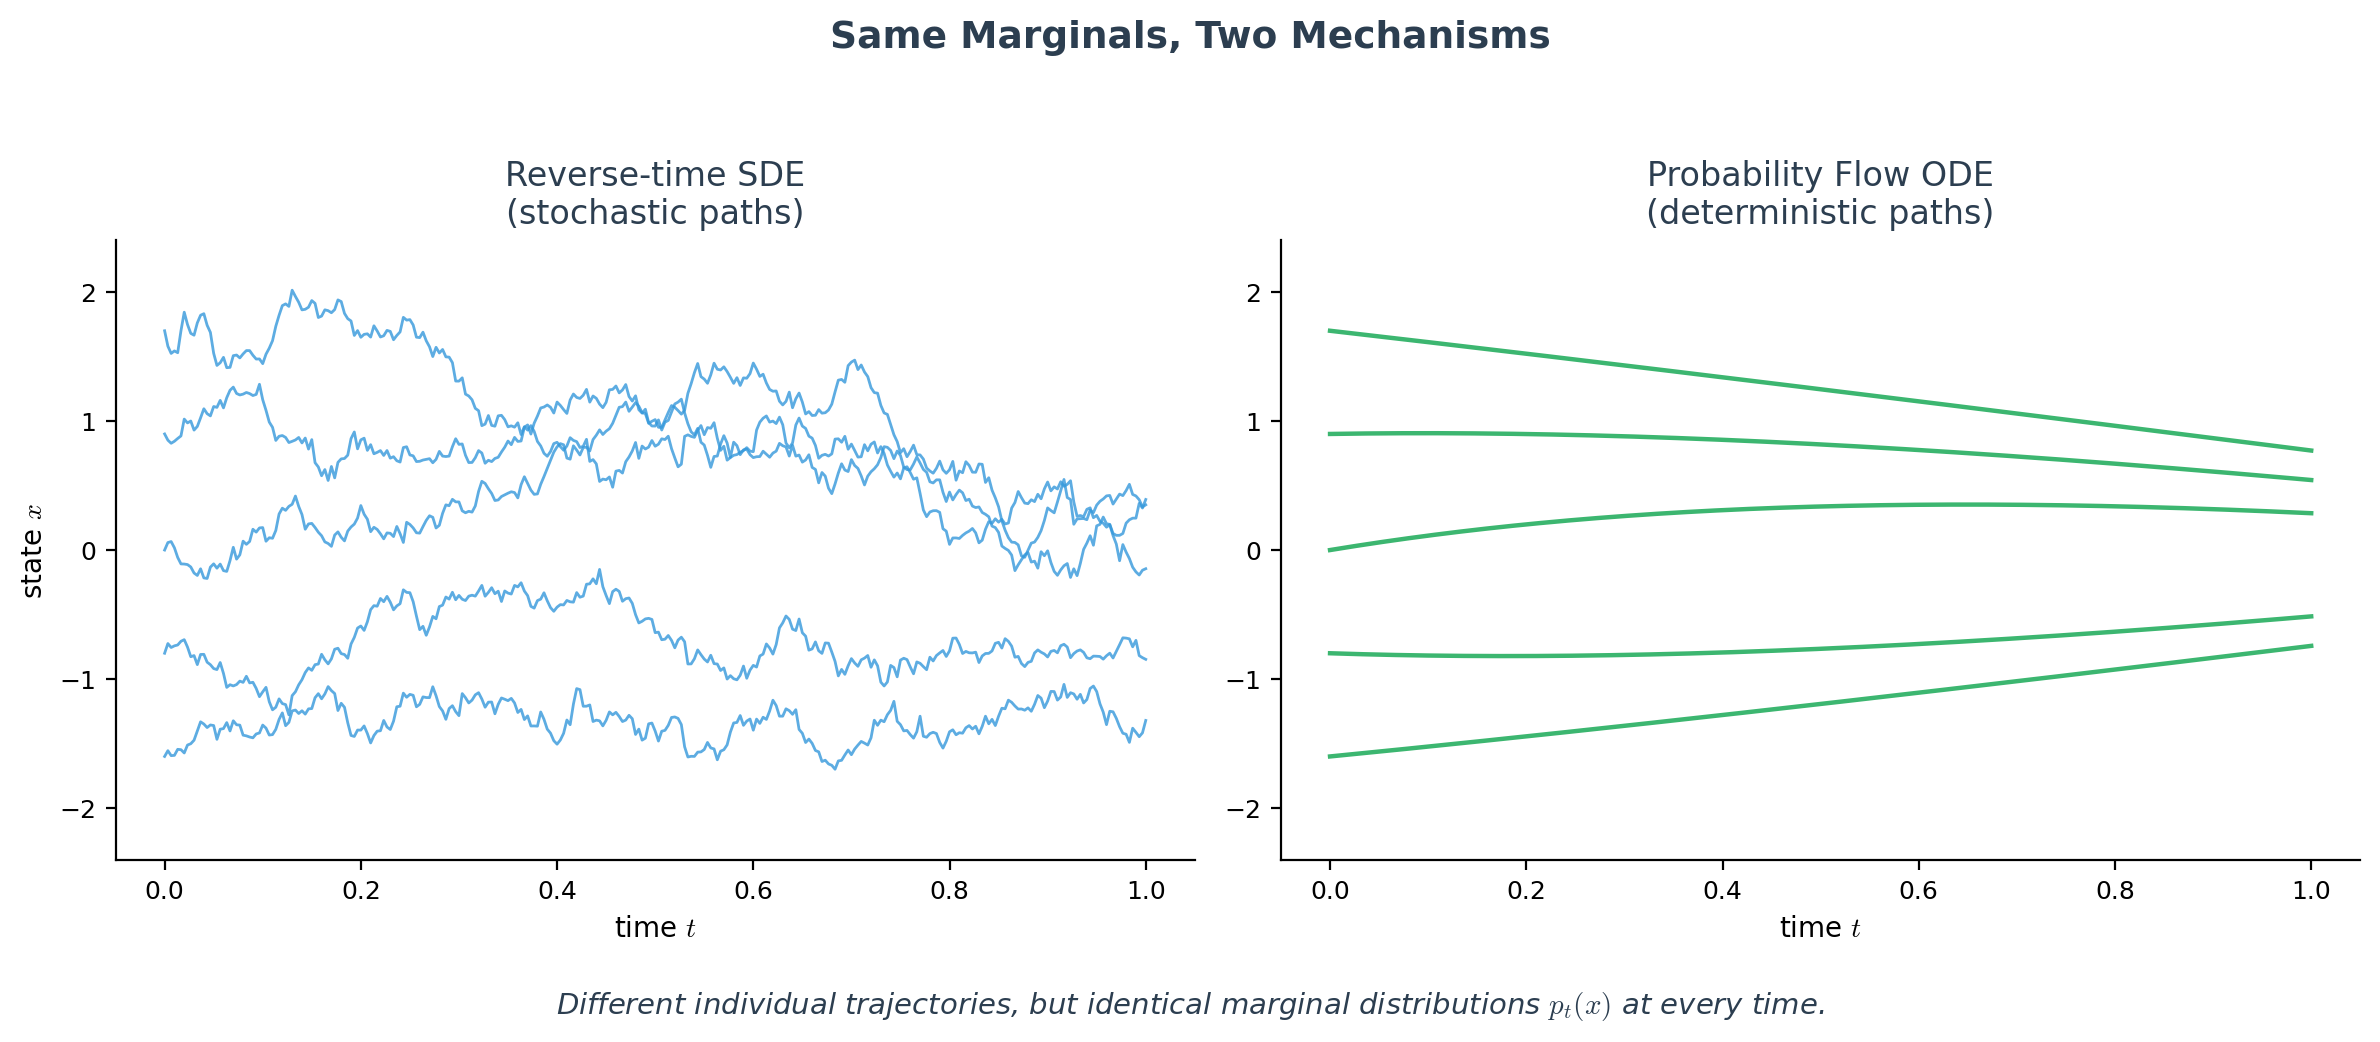
Song et al.(2021)의 가장 중요한 기여 중 하나는, 모든 Diffusion SDE에 대해 동일한 시각별 주변 분포 $p_t(x)$를 공유하는 결정론적 ODE가 존재함을 보인 것입니다. 이를 Probability Flow ODE(확률 흐름 상미분 방정식)라 부릅니다.
이 사실은 다소 놀랍습니다. SDE는 무작위적 궤적을 그리고, ODE는 결정론적 궤적을 그립니다. 개별 표본 경로는 완전히 다릅니다. 그럼에도 불구하고, 만약 우리가 무수히 많은 입자를 각각의 방정식으로 진화시킨다면, 매 시각에 입자들이 이루는 분포는 정확히 같습니다. 즉 SDE와 Probability Flow ODE는 같은 분포의 흐름을 서로 다른 방식으로 구현하는 두 메커니즘입니다.
7.5.2 Probability Flow ODE의 형태
Forward SDE $dx = f(x,t)\,dt + g(t)\,dw$에 대응하는 Probability Flow ODE는 다음과 같습니다.
$$ \frac{dx}{dt} = f(x, t) - \frac{1}{2} g(t)^2 \nabla_x \log p_t(x) $$
이 식의 유도는 Forward SDE가 만족하는 Fokker–Planck 방정식(분포의 시간 변화를 기술하는 편미분 방정식)에서 출발합니다. Fokker–Planck 방정식의 확산 항을 적절히 재배치하면, 동일한 $p_t(x)$를 만족시키는 결정론적 연속 방정식(연속 방정식, continuity equation)을 얻을 수 있으며, 그 흐름의 속도장이 바로 위 ODE의 우변입니다. 자세한 유도는 Song et al.(2021)의 부록에 제시되어 있습니다.
Reverse-time SDE와 비교해 보면 구조적 유사성이 인상적입니다. Reverse SDE의 drift는 $f - g^2 \nabla_x \log p_t$였고, Probability Flow ODE의 우변은 $f - \frac{1}{2} g^2 \nabla_x \log p_t$입니다. Score 항의 계수가 정확히 절반입니다. 직관적으로, ODE는 SDE가 가진 무작위 요동을 제거하는 대신 Score 항을 절반으로 줄임으로써, 평균적으로는 같은 분포 변화를 결정론적으로 재현합니다.
7.5.3 결정론적 흐름이 주는 세 가지 선물
Probability Flow ODE는 단지 이론적 호기심이 아니라, 실용적으로 막대한 이점을 제공합니다.
첫째, 정확한 가능도 계산입니다. ODE는 결정론적 가역 변환이므로, 데이터와 사전 분포 사이의 변환이 11장에서 다룰 Normalizing Flow와 같은 구조를 가집니다. 따라서 변수 변환 공식을 적용하여 임의의 데이터 포인트의 정확한 로그 가능도 $\log p_0(x)$를 계산할 수 있습니다. 이는 SDE 기반 샘플링으로는 직접 얻을 수 없는 능력입니다.
둘째, 빠른 샘플링입니다. ODE는 무작위성이 없으므로, 고차 수치 해법(Runge–Kutta 등)을 사용하여 적은 수의 함수 평가만으로 정확한 샘플을 얻을 수 있습니다. 이것이 다음 절에서 다룰 DDIM과 직결됩니다.
셋째, 가역 인코딩과 잠재 공간 조작입니다. ODE는 데이터 $x_0$와 잠재 표현 $x_T$ 사이의 일대일 결정론적 대응을 제공합니다. 따라서 이미지를 잠재 공간으로 정확히 인코딩했다가 복원할 수 있으며, 잠재 공간에서의 보간(interpolation)이 의미 있는 이미지 변형으로 이어집니다.
7.6 이산화와 샘플링 알고리즘
연속 시간 SDE/ODE는 수학적으로 우아하지만, 실제로 샘플을 생성하려면 이를 다시 이산화하여 수치적으로 풀어야 합니다. 이 단계에서 어떤 해법을 선택하느냐가 곧 샘플링 알고리즘의 차이를 만듭니다.
7.6.1 Euler–Maruyama 방법
SDE를 푸는 가장 기본적인 방법은 Euler–Maruyama 이산화입니다. 이는 결정론적 ODE의 Euler 방법을 확률적으로 확장한 것으로, Reverse-time SDE에 적용하면 다음과 같습니다.
$$ x_{t-\Delta t} = x_t - \left[ f(x_t, t) - g(t)^2 s_\theta(x_t, t) \right] \Delta t + g(t)\sqrt{\Delta t}\, z, \quad z \sim \mathcal{N}(0, \mathbf{I}) $$
이 이산화를 VP-SDE에 적용하면, 우리는 5장에서 본 DDPM의 조상(ancestral) 샘플링과 본질적으로 동일한 갱신 규칙을 회복합니다. 즉 DDPM의 샘플링은 VP-SDE의 Reverse-time SDE를 Euler–Maruyama로 푼 특수한 경우인 것입니다.
7.6.2 Predictor–Corrector 샘플러
Song et al.(2021)은 수치 해법의 오차를 보정하기 위한 Predictor–Corrector(PC) 프레임워크를 제안했습니다. 아이디어는 두 단계를 결합하는 것입니다. Predictor 단계에서는 Euler–Maruyama 같은 수치 SDE 해법으로 다음 시각의 상태를 한 걸음 예측합니다. 그 다음 Corrector 단계에서는, 현재 시각에서 학습된 Score를 이용한 Langevin Dynamics(6장 참조)를 몇 차례 적용하여 표본이 정확한 주변 분포 $p_t$를 따르도록 교정합니다.
이렇게 수치 적분(predictor)과 MCMC 기반 교정(corrector)을 번갈아 적용하면, 단순한 Euler–Maruyama보다 훨씬 높은 표본 품질을 얻을 수 있습니다. 이는 연속 시간 관점이 단지 통합적 이해뿐 아니라 새로운 알고리즘까지 낳는다는 것을 보여주는 대표적 사례입니다.
7.6.3 ODE 해법과 DDIM
Probability Flow ODE를 수치적으로 풀면 결정론적 샘플러를 얻습니다. 그런데 놀랍게도, 이렇게 얻어지는 샘플러가 바로 DDIM(Song, Meng & Ermon, 2021)입니다. DDIM은 원래 비마르코프(non-Markovian) 추론 과정을 통해 도출되었지만, 연속 시간 관점에서 보면 VP-SDE의 Probability Flow ODE에 대한 특정 이산화로 정확히 해석됩니다.
DDIM이 DDPM 대비 10배에서 50배 빠른 샘플링을 달성할 수 있었던 이유가 여기서 자연스럽게 설명됩니다. ODE는 무작위성이 없어 큰 시간 간격으로도 안정적으로 적분할 수 있으므로, 적은 단계만으로 고품질 샘플을 생성할 수 있는 것입니다. Karras et al.(2022)은 한 걸음 더 나아가, 이 ODE 관점에서 노이즈 스케줄·전처리(preconditioning)·해법 선택을 체계적으로 분리하여 샘플링 효율과 품질을 모두 크게 개선했습니다.
7.7 통합적 관점: 모든 길은 SDE로 통한다
이제 우리는 지금까지 별개로 배웠던 여러 방법을 하나의 그림 안에 배치할 수 있습니다. 연속 시간 SDE/ODE 프레임워크 안에서 각 방법은 다음과 같이 재해석됩니다.
| 방법 | 연속 시간 해석 | 샘플링 |
|---|---|---|
| DDPM (Ho et al., 2020) | VP-SDE | Reverse SDE의 Euler–Maruyama 이산화 |
| NCSN/SMLD (Song & Ermon, 2019) | VE-SDE | Annealed Langevin Dynamics |
| DDIM (Song et al., 2021) | VP-SDE의 Probability Flow ODE | 결정론적 ODE 해법 |
이 통합이 가져온 실질적 결과는 다음과 같습니다. 첫째, 학습은 한 번만 하면 됩니다. 시간 의존적 Score $s_\theta(x, t)$ 하나를 학습하면, 동일한 모델을 SDE 샘플러로도 ODE 샘플러로도 사용할 수 있습니다. 둘째, 샘플링 단계 수를 학습과 독립적으로 자유롭게 선택할 수 있습니다. 셋째, 정확한 가능도, 가역 인코딩, 그리고 8장에서 다룰 다양한 조건부 생성 기법이 모두 이 프레임워크 위에서 원리적으로 도출됩니다.
7.8 요약 및 다음 장 예고
이번 장에서 우리는 이산 시간 Diffusion을 연속 시간으로 확장하여, SDE와 ODE라는 통합적 언어를 얻었습니다.
단계 수를 무한히 늘린 연속 극한에서 Diffusion의 Forward Process는 확률 미분 방정식 $dx = f(x,t)\,dt + g(t)\,dw$가 됩니다. drift $f$와 diffusion $g$의 선택에 따라 DDPM은 VP-SDE로, NCSN은 VE-SDE로 통합됩니다. Anderson(1982)의 정리에 따르면 이 과정의 시간 역전은 또 하나의 확산 과정이며, 그 Reverse-time SDE의 drift에는 Score Function $\nabla_x \log p_t(x)$가 핵심적으로 등장합니다. 이 Score는 6장의 Denoising Score Matching을 모든 시각에 확장하여 학습합니다. 나아가 모든 Diffusion SDE에는 동일한 주변 분포를 공유하는 결정론적 Probability Flow ODE가 존재하며, 이는 정확한 가능도 계산·빠른 샘플링·가역 인코딩을 가능케 합니다. DDIM은 바로 이 Probability Flow ODE의 결정론적 해법으로 재해석됩니다.
참고문헌
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., & Poole, B. (2021). Score-Based Generative Modeling through Stochastic Differential Equations. International Conference on Learning Representations (ICLR). arXiv:2011.13456
- Anderson, B. D. O. (1982). Reverse-time diffusion equation models. Stochastic Processes and their Applications, 12(3), 313-326.
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. Advances in Neural Information Processing Systems, 33, 6840-6851. arXiv:2006.11239
- Song, Y., & Ermon, S. (2019). Generative Modeling by Estimating Gradients of the Data Distribution. Advances in Neural Information Processing Systems, 32, 11895-11907. arXiv:1907.05600
- Song, J., Meng, C., & Ermon, S. (2021). Denoising Diffusion Implicit Models. International Conference on Learning Representations (ICLR). arXiv:2010.02502
- Karras, T., Aittala, M., Aila, T., & Laine, S. (2022). Elucidating the Design Space of Diffusion-Based Generative Models. Advances in Neural Information Processing Systems, 35. arXiv:2206.00364
'인공지능 논문 정리 > Diffusiion' 카테고리의 다른 글
| [Diffusion 9] Optimal Transport 입문: Wasserstein 거리와 최적 경로 (0) | 2026.06.12 |
|---|---|
| [Diffusion 8] Guidance의 수학: 조건부 생성을 가능케 하는 원리 (0) | 2026.06.11 |
| [Diffusion 6] Score Function이란 무엇인가: Score Matching에 대한 이해 (2) | 2026.01.20 |
| [Diffusion 5] DDPM 논문 완전 정복 (하): Reverse Process와 학습 (0) | 2026.01.19 |
| [Diffusion 4] DDPM 논문 완전 정복 (상): Forward Process (0) | 2026.01.18 |


