Guidance can be performed by a pure generative model without such a classifier.
Ho & Salimans, Classifier-Free Diffusion Guidance (2022)
7장에서 우리는 이산 시간 Diffusion을 연속 시간으로 확장하여, Forward SDE와 그 시간 역전인 Reverse-time SDE, 그리고 동일한 주변 분포를 공유하는 Probability Flow ODE라는 통합적 언어를 얻었습니다. 그 모든 과정의 한가운데에는 6장에서 정의한 Score Function $\nabla_x \log p_t(x)$가 있었습니다. 그런데 지금까지 우리가 다룬 생성은 모두 무조건부(unconditional) 생성이었습니다. 즉 모델은 데이터 분포 $p(x)$로부터 무언가를 그럴듯하게 만들어 낼 뿐, "고양이 사진을 그려라", "숫자 7을 생성하라"처럼 우리가 원하는 것을 지정할 방법이 없었습니다.
이번 장에서는 텍스트 캡션, 클래스 레이블, 또는 다른 이미지와 같은 조건 $y$가 주어졌을 때 그 조건을 만족하는 샘플을 생성하는 조건부 생성(conditional generation)의 수학을 탐구합니다. 놀랍게도, 7장에서 익힌 Score Function의 언어가 다시 한번 핵심 역할을 합니다. 조건부 Score $\nabla_x \log p_t(x \mid y)$를 베이즈 정리로 분해하는 단 한 줄의 식에서, 오늘날 모든 텍스트-이미지 생성 모델의 심장인 두 가지 기법, Classifier Guidance와 Classifier-Free Guidance이 자연스럽게 따라 나옵니다.
8.1 조건부 생성이란 무엇인가
8.1.1 무조건부에서 조건부로
지금까지의 Diffusion Model은 데이터 분포 $p(x)$를 학습하고 그로부터 샘플을 추출했습니다. 그러나 실용적인 생성 모델에는 거의 항상 제어가 필요합니다. 우리는 임의의 이미지가 아니라 "주황색 고양이가 소파에 앉아 있는 사진"을, 임의의 숫자가 아니라 "숫자 3"을 원합니다. 이러한 요구를 수학적으로 표현하면, 조건 $y$가 주어졌을 때의 조건부 분포(conditional distribution) $p(x \mid y)$로부터 샘플링하는 문제가 됩니다.
여기서 조건 $y$는 다양한 형태를 가질 수 있습니다.
첫째, 클래스 레이블입니다. ImageNet의 1000개 클래스 중 하나처럼, $y$가 이산적인 범주를 나타내는 경우입니다. 둘째, 텍스트 캡션입니다. "a photorealistic image of a corgi playing the trumpet"와 같은 자연어 설명으로, 오늘날 텍스트-이미지 모델의 표준적인 조건 형태입니다. 셋째, 다른 이미지나 구조 정보입니다. 저해상도 이미지(초해상도), 스케치, 깊이 맵, 또는 마스크 영역(인페인팅) 등이 여기에 속합니다.
8.1.2 가장 단순한 접근: 조건을 입력으로 넣기
조건부 생성의 가장 직접적인 방법은 신경망에 조건 $y$를 추가 입력으로 제공하는 것입니다. 즉 노이즈 예측 네트워크를 $\epsilon_\theta(x_t, t)$ 대신 $\epsilon_\theta(x_t, t, y)$로 확장하고, 학습 시 데이터-조건 쌍 $(x_0, y)$를 사용하여 동일한 노이즈 예측 손실로 최적화하는 것입니다.
$$ L = \mathbb{E}_{t, (x_0, y), \epsilon}\left[ \left\| \epsilon - \epsilon_\theta(x_t, t, y) \right\|^2 \right], \quad x_t = \sqrt{\bar{\alpha}_t}\, x_0 + \sqrt{1-\bar{\alpha}_t}\, \epsilon $$
이 방법은 분명히 작동합니다. 그러나 Dhariwal & Nichol(2021)이 관찰한 중요한 사실은, 이렇게 단순히 조건을 입력으로 넣기만 하면 생성된 샘플이 조건 $y$를 충분히 강하게 반영하지 못하는 경향이 있다는 것입니다. 모델은 $p(x \mid y)$를 학습하긴 하지만, 우리는 종종 조건과의 일치도(fidelity)를 더 끌어올리는 대신 다양성(diversity)을 조금 희생하기를 원합니다. 이 trade-off를 명시적으로 제어하는 손잡이가 바로 Guidance입니다. 그리고 그 손잡이의 수학적 출발점은 조건부 Score의 분해입니다.
8.2 조건부 Score의 베이즈 분해
7장에서 우리는 Reverse-time SDE와 Probability Flow ODE의 핵심이 시간 $t$에서의 Score Function $\nabla_x \log p_t(x)$임을 보았습니다. 조건부 생성에서 우리에게 필요한 것은 조건부 Score $\nabla_x \log p_t(x \mid y)$입니다. 이것을 어떻게 구할 수 있을까요?
출발점은 베이즈 정리입니다. 시각 $t$에서의 조건부 밀도는 다음과 같이 분해됩니다.
$$ p_t(x \mid y) = \frac{p_t(y \mid x)\, p_t(x)}{p_t(y)} $$
양변에 로그를 취하면,
$$ \log p_t(x \mid y) = \log p_t(y \mid x) + \log p_t(x) - \log p_t(y) $$
이제 양변을 데이터 $x$에 대해 미분합니다. 여기서 핵심은 마지막 항 $\log p_t(y)$가 $x$에 의존하지 않으므로 그 그래디언트가 0이 된다는 점입니다.
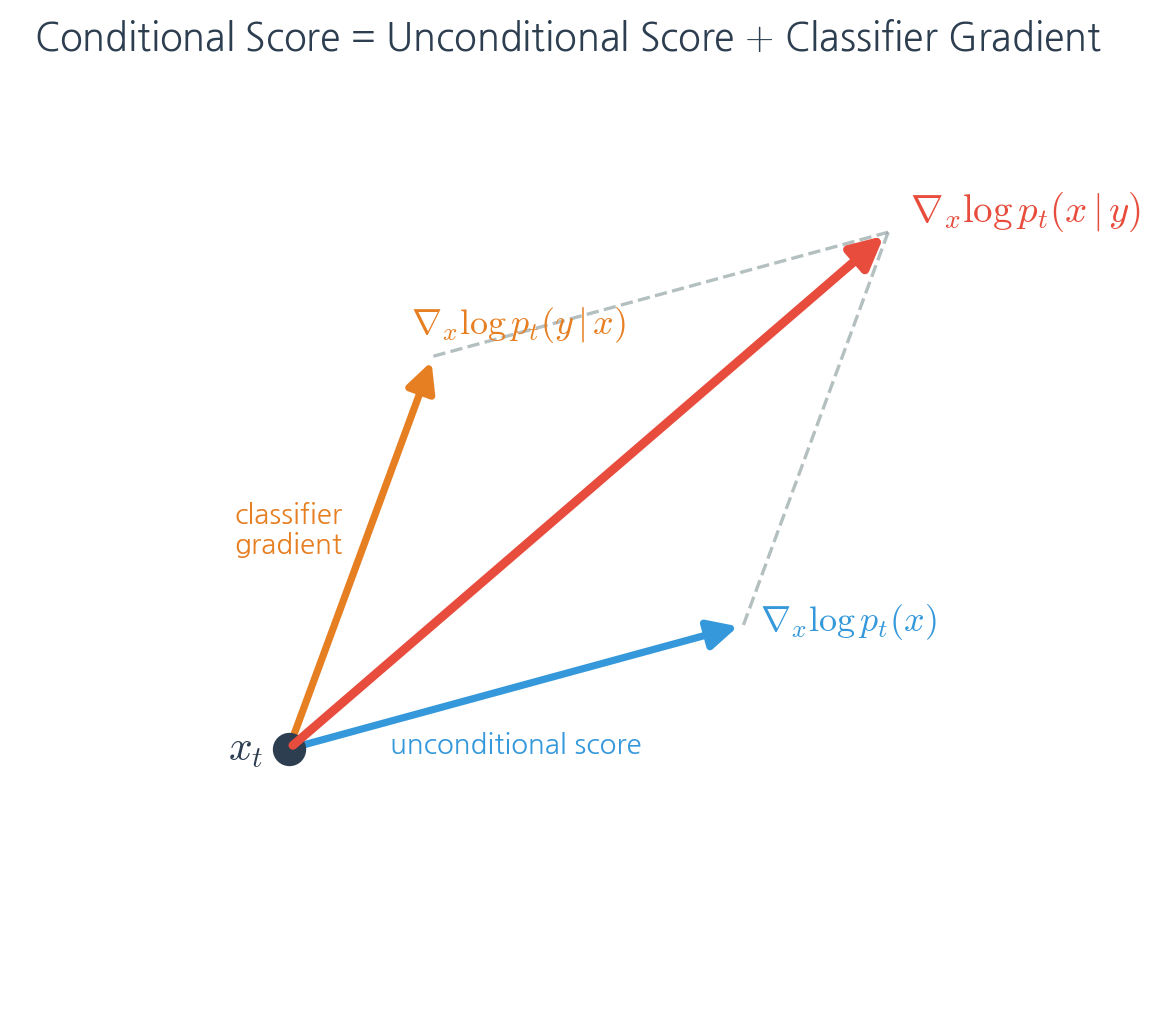
$$ \nabla_x \log p_t(x \mid y) = \nabla_x \log p_t(x) + \nabla_x \log p_t(y \mid x) $$
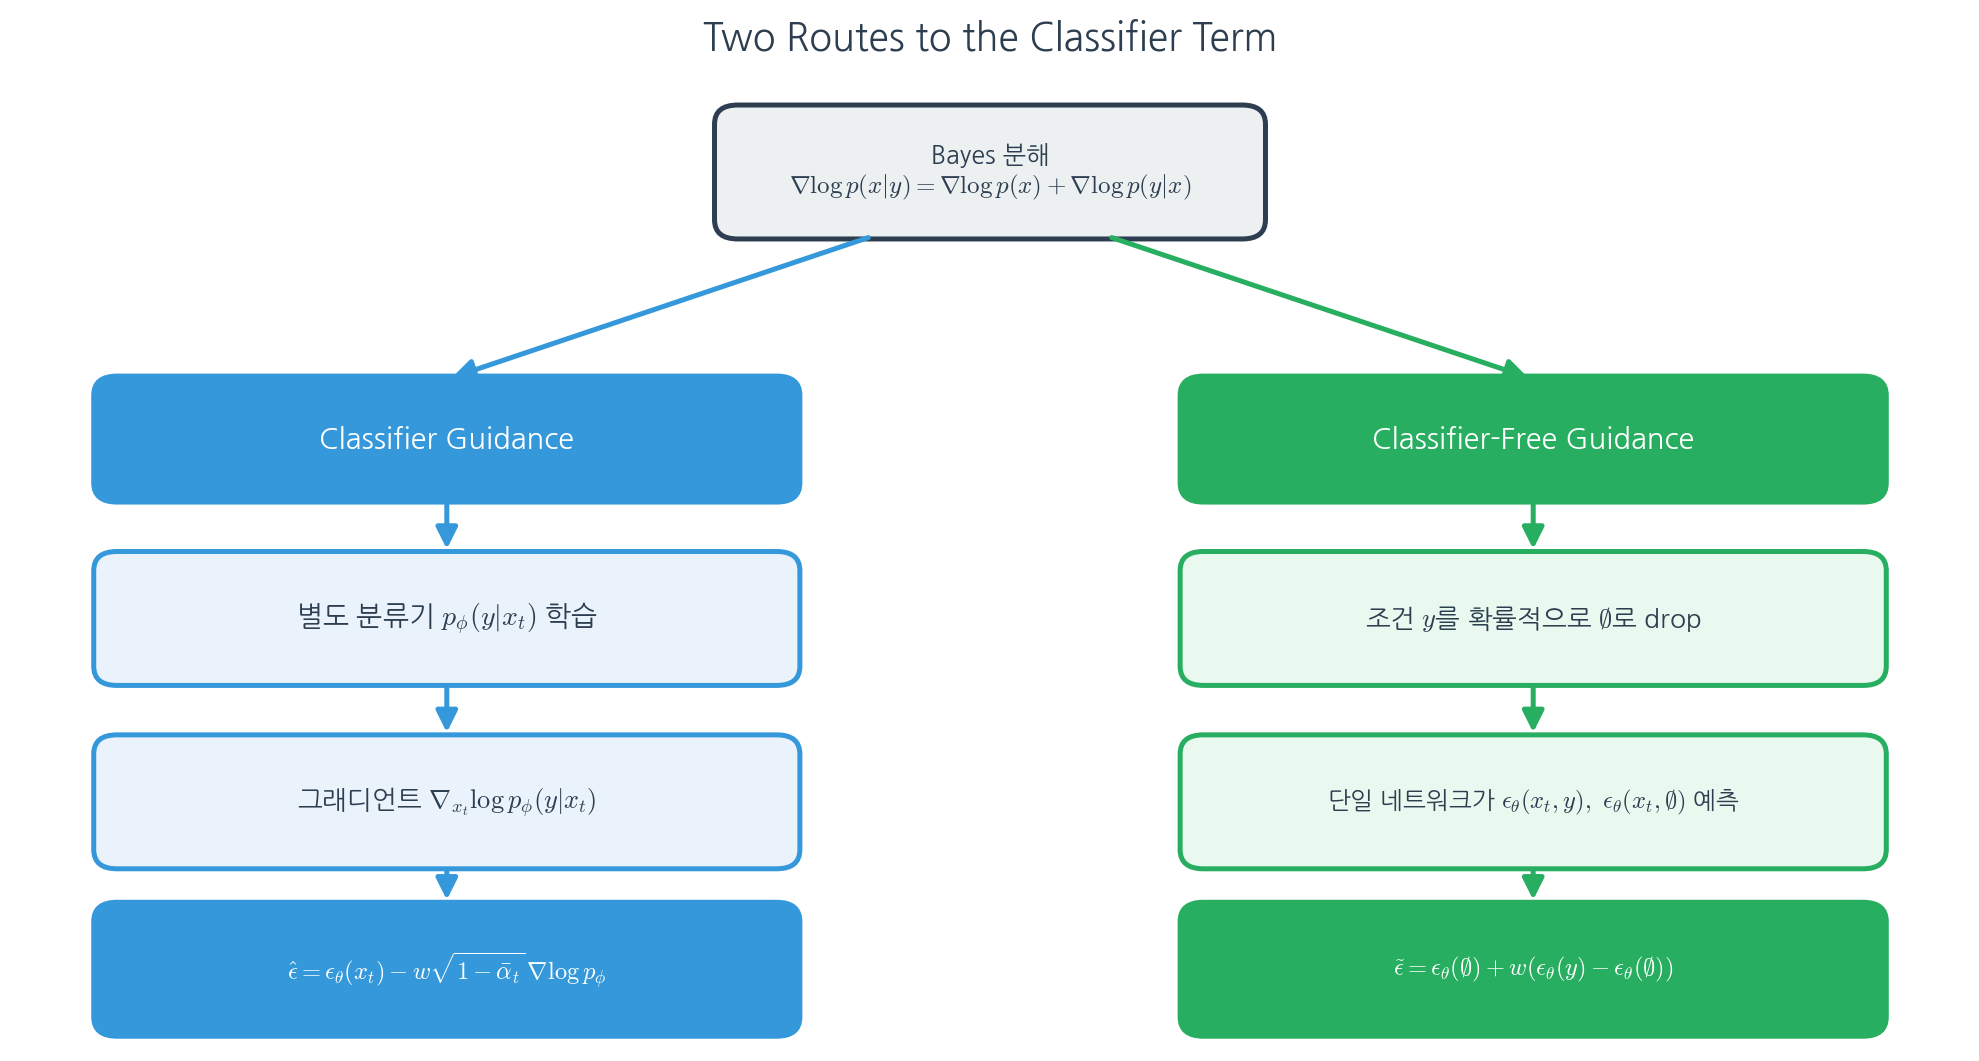
이 한 줄의 식이 이번 장 전체의 토대입니다. 두 번째 항을 어떻게 얻느냐에 따라 두 가지 접근이 갈립니다. 별도의 분류기를 명시적으로 학습하면 Classifier Guidance가 되고, 분류기를 우회하여 생성 모델 자체로부터 그 항을 유도하면 Classifier-Free Guidance가 됩니다.
8.3 Classifier Guidance
8.3.1 별도의 분류기 학습
Dhariwal & Nichol(2021)이 제안한 Classifier Guidance는 위 분해의 두 번째 항을 정직하게 계산합니다. 즉 노이즈가 섞인 데이터 $x_t$에 대해 조건 $y$를 예측하는 별도의 분류기 $p_\phi(y \mid x_t)$를 학습합니다. 여기서 주의할 점은, 이 분류기가 깨끗한 이미지가 아니라 모든 노이즈 레벨의 $x_t$에 대해 동작하도록 학습되어야 한다는 것입니다. 분류기가 준비되면, 우리는 그 로그 가능도의 그래디언트 $\nabla_{x_t} \log p_\phi(y \mid x_t)$를 분류기 항으로 사용합니다.
8.3.2 Guidance Scale의 도입
8.2절의 분해를 그대로 적용하면 조건부 Score를 정확히 복원할 수 있습니다. 그러나 Dhariwal & Nichol은 분류기 항에 가중치 $w \geq 1$를 곱하여 그 영향력을 증폭하면 샘플 품질이 크게 향상됨을 발견했습니다.
$$ \nabla_{x_t} \log \tilde{p}_t(x_t \mid y) = \nabla_{x_t} \log p_t(x_t) + w \, \nabla_{x_t} \log p_\phi(y \mid x_t) $$
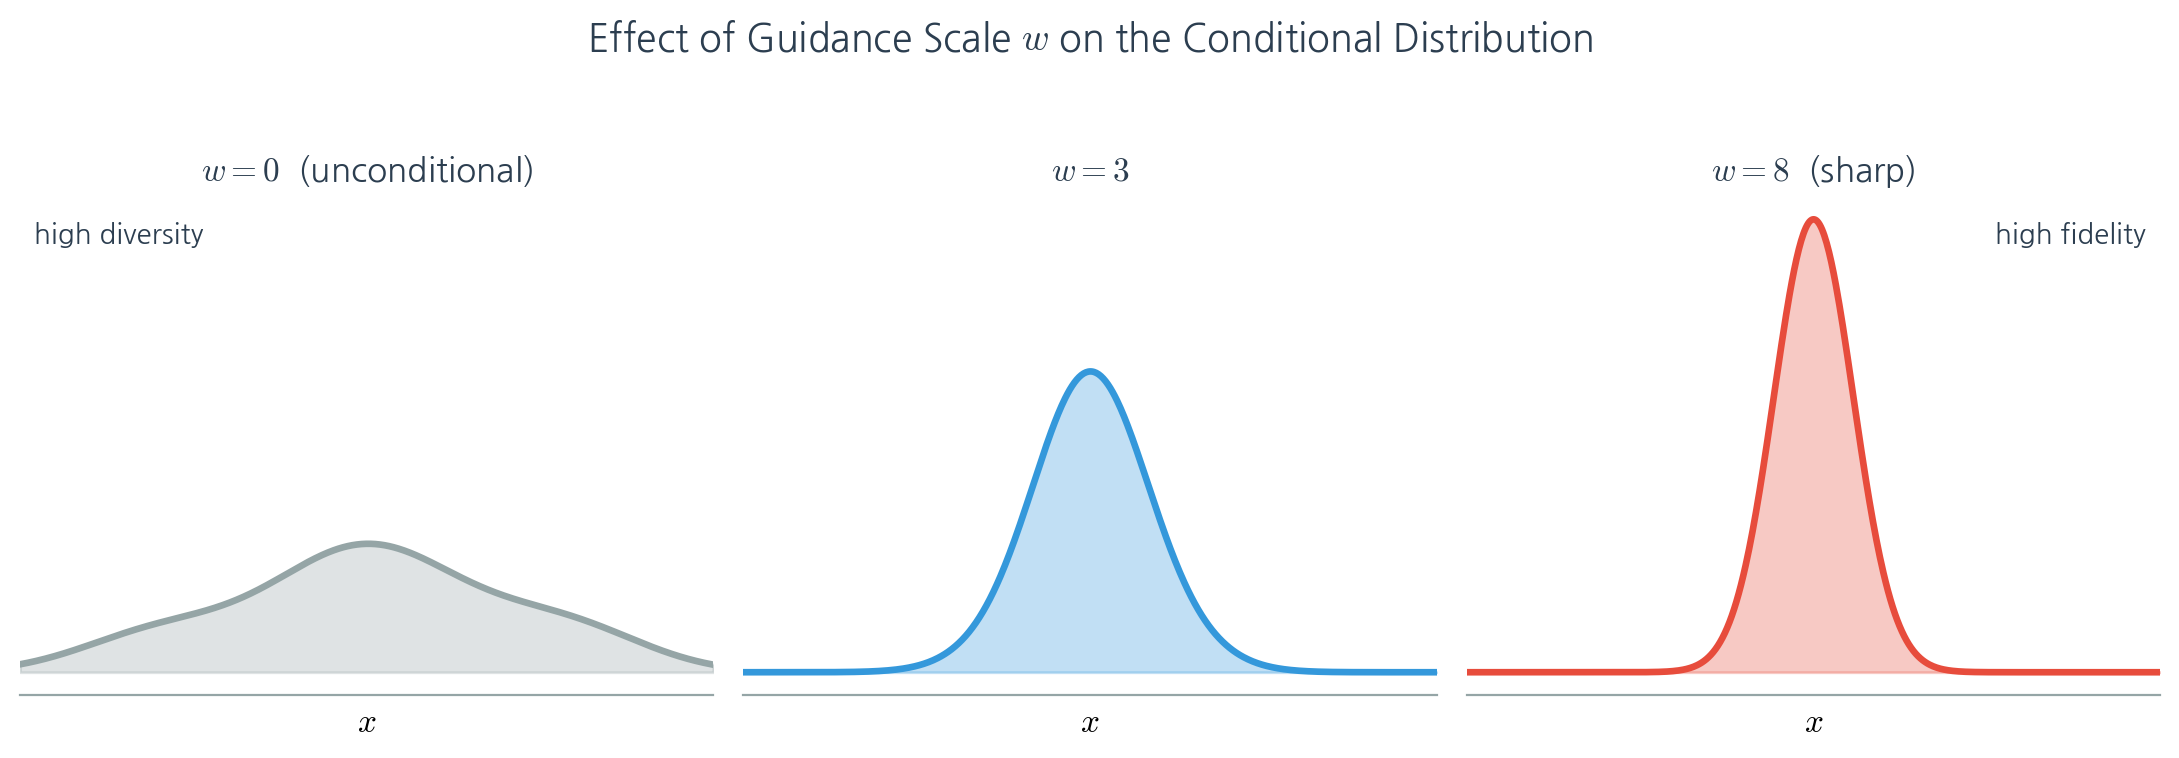
여기서 $w$를 guidance scale이라 부릅니다. $w = 1$이면 정확한 조건부 Score이고, $w > 1$이면 분류기가 더 확신하는 방향으로 샘플을 더 강하게 밀어붙입니다. 직관적으로 이것은 분류기 분포 $p_\phi(y \mid x_t)$를 $w$ 제곱하여 $p_\phi(y \mid x_t)^w$로 날카롭게 만드는 것과 같습니다. $w$가 클수록 조건과의 일치도(fidelity)는 높아지지만, 생성 샘플의 다양성(diversity)은 줄어듭니다. 이것이 Guidance의 본질적인 diversity–fidelity trade-off입니다.
8.3.3 노이즈 예측 형태로의 변환
실제 DDPM 구현은 Score $s_\theta$가 아니라 노이즈 예측 $\epsilon_\theta$를 사용합니다. 6장에서 본 두 표현의 관계는 다음과 같았습니다.
$$ s_\theta(x_t, t) = \nabla_{x_t} \log p_t(x_t) = -\frac{1}{\sqrt{1-\bar{\alpha}_t}}\, \epsilon_\theta(x_t, t) $$
이 관계를 guidance가 적용된 Score에 대입하면, guidance가 반영된 새로운 노이즈 예측 $\hat{\epsilon}$를 얻을 수 있습니다.
$$ \hat{\epsilon}(x_t, t) = \epsilon_\theta(x_t, t) - w \sqrt{1-\bar{\alpha}_t}\, \nabla_{x_t} \log p_\phi(y \mid x_t) $$
즉 매 샘플링 단계에서, 무조건부 노이즈 예측 $\epsilon_\theta(x_t, t)$에 분류기 그래디언트를 빼 주는 보정을 가합니다. 부호가 음수인 이유는 Score와 노이즈가 부호 반대의 관계이기 때문입니다. 이렇게 보정된 $\hat{\epsilon}$를 사용하여 평소처럼 reverse step을 진행하면, 샘플이 조건 $y$를 향하도록 유도됩니다.
8.3.4 Classifier Guidance의 한계
Classifier Guidance는 강력하지만 몇 가지 실용적 비용을 수반합니다.
첫째, 별도의 분류기를 학습해야 합니다. 더구나 이 분류기는 깨끗한 데이터가 아니라 모든 노이즈 레벨의 $x_t$에 대해 견고하게 동작해야 하므로, 기성 사전학습 분류기를 그대로 가져다 쓸 수 없고 노이즈 데이터로 다시 학습해야 합니다. 둘째, 샘플링 매 단계마다 분류기에 대한 그래디언트 역전파가 필요하여 계산 비용이 추가됩니다. 셋째, 분류기 그래디언트는 종종 적대적 예제(adversarial example)와 유사한 방향을 가리켜, 분류기를 속이는 방향으로 샘플이 망가질 위험이 있습니다. 이러한 한계들이 다음 절에서 다룰 Classifier-Free Guidance의 동기가 됩니다.
8.4 Classifier-Free Guidance
8.4.1 분류기 항을 생성 모델로 대체하기
Ho & Salimans(2022)의 핵심 질문은 단순합니다. 분류기 없이 guidance를 수행할 수 있는가? 답은 다시 8.2절의 베이즈 분해에 있습니다. 그 식을 분류기 항 $\nabla_{x_t} \log p_t(y \mid x_t)$에 대해 정리하면,
$$ \nabla_{x_t} \log p_t(y \mid x_t) = \nabla_{x_t} \log p_t(x_t \mid y) - \nabla_{x_t} \log p_t(x_t) $$
이것이 결정적인 통찰입니다. 분류기 그래디언트는 조건부 Score에서 무조건부 Score를 뺀 것과 정확히 같습니다. 따라서 우리가 조건부 Score와 무조건부 Score를 둘 다 가지고 있다면, 별도의 분류기를 학습하지 않고도 분류기 항을 암묵적으로(implicitly) 얻을 수 있습니다. Ho & Salimans은 이를 "암묵적 분류기(implicit classifier)"라고 불렀습니다.
8.4.2 하나의 네트워크로 두 Score를 학습하는 트릭
그렇다면 조건부와 무조건부 Score를 어떻게 동시에 얻을까요? 두 개의 별도 모델을 학습하는 것은 비효율적입니다. Ho & Salimans의 해법은 우아합니다. 하나의 조건부 네트워크 $\epsilon_\theta(x_t, t, y)$를 학습하되, 학습 중 일정 확률(예: 10~20%)로 조건 $y$를 널 토큰(null token) $\emptyset$으로 대체합니다.
구체적으로, 각 학습 단계에서 일정 확률 $p_{\text{uncond}}$로 조건을 버리고 $y \leftarrow \emptyset$로 둡니다. 이렇게 하면 같은 네트워크가 다음 두 가지를 동시에 학습합니다. 조건 $y$가 주어졌을 때는 조건부 노이즈 $\epsilon_\theta(x_t, t, y)$를, 조건이 $\emptyset$일 때는 무조건부 노이즈 $\epsilon_\theta(x_t, t, \emptyset)$를 예측하게 됩니다. 무조건부 모델은 사실상 조건이 비어 있는 특수한 경우로 자연스럽게 흡수됩니다.
8.4.3 Classifier-Free Guidance 공식
학습이 끝나면, 샘플링 시 두 예측을 조합합니다. 8.4.1절의 분류기 항을 노이즈 예측의 차이로 바꾸어 쓰면, guidance가 적용된 노이즈 예측은 다음과 같이 됩니다.
$$ \tilde{\epsilon}_\theta(x_t, t, y) = \epsilon_\theta(x_t, t, \emptyset) + w \cdot \big( \epsilon_\theta(x_t, t, y) - \epsilon_\theta(x_t, t, \emptyset) \big) $$
이것이 Classifier-Free Guidance(CFG)의 핵심 공식입니다. 식을 해석해 봅시다. 괄호 안의 $\epsilon_\theta(x_t, t, y) - \epsilon_\theta(x_t, t, \emptyset)$는 "조건이 없을 때와 비교해, 조건 $y$가 예측을 어느 방향으로 바꾸는가"를 나타내는 벡터입니다. 우리는 무조건부 예측에서 출발하여 이 차이 벡터를 $w$배 만큼 따라갑니다.
가중치 $w$의 역할은 명확합니다. $w = 0$이면 $\tilde{\epsilon} = \epsilon_\theta(x_t, t, \emptyset)$로 순수한 무조건부 생성이 됩니다. $w = 1$이면 $\tilde{\epsilon} = \epsilon_\theta(x_t, t, y)$로 정확한 조건부 생성이 됩니다. 그리고 $w > 1$이면 조건의 영향을 무조건부 방향으로부터 외삽(extrapolation)하여 더욱 강조합니다. 실무에서는 흔히 $w$를 3에서 15 사이의 값으로 두어 조건과의 일치도를 크게 높입니다.
8.5 CFG는 왜 잘 작동하는가
8.5.1 조건부 분포를 날카롭게 만들기
Classifier Guidance에서 $w > 1$이 분류기 분포를 $p_\phi(y \mid x)^w$로 날카롭게 만드는 것과 마찬가지로, CFG의 외삽도 결과적으로 조건부 분포를 날카롭게 만드는 효과를 냅니다. 베이즈 분해를 다시 떠올리면, CFG의 guided score는 다음과 같이 정리됩니다.
$$ \nabla_{x_t} \log \tilde{p}_t(x_t \mid y) = \nabla_{x_t} \log p_t(x_t) + w \, \big( \nabla_{x_t} \log p_t(x_t \mid y) - \nabla_{x_t} \log p_t(x_t) \big) $$
이것은 암묵적 분류기 $p_t(y \mid x_t)$를 $w$ 제곱한 분포를 향하는 Score와 같습니다. 즉 CFG는 조건과 잘 맞는 영역의 확률 질량을 키우고, 조건과 어긋나는 영역을 억제하여, 샘플이 "조건 $y$의 전형적인 예시"에 더 가깝도록 끌어당깁니다.
8.5.2 외삽의 기하학
또 다른 직관은 벡터의 외삽입니다. 무조건부 예측 $\epsilon_\theta(x_t, t, \emptyset)$를 기준점으로 두고, 조건이 그 예측을 어디로 옮기는지를 나타내는 차이 벡터를 그 기준점 너머로 $w$배 연장하는 것입니다. 이렇게 하면 샘플은 조건의 영향이 강하게 반영되는 방향으로 더 멀리 이동합니다.
다만 이 외삽에는 대가가 따릅니다. $w$를 지나치게 키우면 샘플이 분포의 전형적인 영역(typical set)을 벗어나, 색상이 과포화되거나 부자연스러운 인공물이 나타나기 쉽습니다. 따라서 적절한 $w$의 선택은 일치도와 자연스러움 사이의 균형을 맞추는 작업이 됩니다.
8.5.3 두 기법의 비교
Classifier Guidance와 Classifier-Free Guidance는 동일한 베이즈 분해에서 출발하지만, 분류기 항을 얻는 방식이 다릅니다. 두 기법의 차이를 정리하면 다음과 같습니다.
| 분류기 항 출처 | 별도 분류기 $p_\phi(y \mid x_t)$의 그래디언트 | $\epsilon_\theta(x_t,t,y) - \epsilon_\theta(x_t,t,\emptyset)$ |
| 추가 모델 | 노이즈 견고 분류기 필요 | 없음(단일 네트워크) |
| 학습 트릭 | 분류기를 별도 학습 | 조건 $y$를 확률적으로 $\emptyset$로 drop |
| 샘플링 비용 | 분류기 역전파 추가 | 조건/무조건 예측 2회 평가 |
| 대표 적용 | ImageNet 클래스 조건 생성 | 텍스트-이미지 생성(GLIDE 등) |
8.6 실제 적용: 텍스트-이미지 생성
Classifier-Free Guidance가 실용적 영향력을 발휘한 대표적 사례는 텍스트-이미지 생성입니다. Nichol et al.(2022)의 GLIDE는 두 가지 guidance 전략인 CLIP을 분류기로 사용하는 CLIP guidance와 Classifier-Free Guidance을 비교하였고, 후자가 사진 같은 사실성과 캡션 일치도 양쪽에서 사람 평가자에게 더 선호됨을 보였습니다. 텍스트 조건의 경우 "분류기"를 정의하기가 까다롭다는 점을 생각하면, 분류기를 아예 필요로 하지 않는 CFG의 장점은 더욱 두드러집니다. 여기서 널 토큰 $\emptyset$은 자연스럽게 "빈 캡션"으로 구현됩니다.
오늘날 대부분의 텍스트-이미지 Diffusion 모델은 CFG를 표준적으로 채택하고 있으며, guidance scale은 사용자가 직접 조절할 수 있는 핵심 하이퍼파라미터로 노출되는 경우가 많습니다. 이 하나의 손잡이가 8.2절의 단순한 베이즈 분해로부터 직접 유도된다는 사실은, 이론적 통찰이 어떻게 실용적 도구로 이어지는지를 잘 보여 줍니다.
8.7 요약 및 다음 장 예고
이번 장에서 우리는 무조건부 생성을 조건부 생성으로 확장하는 Guidance의 수학을 살펴보았습니다.
조건부 생성의 목표는 $p(x \mid y)$로부터의 샘플링이며, 그 핵심은 조건부 Score $\nabla_x \log p_t(x \mid y)$입니다. 베이즈 정리는 이를 무조건부 Score $\nabla_x \log p_t(x)$와 분류기 항 $\nabla_x \log p_t(y \mid x)$의 합으로 분해합니다. Classifier Guidance는 노이즈에 견고한 별도 분류기를 학습하여 분류기 항을 직접 계산하고, guidance scale $w$로 그 영향을 증폭하여 diversity–fidelity trade-off를 제어합니다. Classifier-Free Guidance는 같은 분해를 뒤집어 분류기 항을 조건부·무조건부 Score의 차이로 표현하고, 학습 중 조건을 확률적으로 drop하는 트릭으로 단일 네트워크에서 두 예측을 동시에 얻습니다. 그 결과 얻어지는 공식 $\tilde{\epsilon} = \epsilon_\theta(x_t, \emptyset) + w(\epsilon_\theta(x_t, y) - \epsilon_\theta(x_t, \emptyset))$는 오늘날 텍스트-이미지 생성의 사실상 표준이 되었습니다. 두 기법 모두 7장에서 익힌 Score Function의 언어 위에서 자연스럽게 도출된다는 점이 인상적입니다.
참고문헌
- Dhariwal, P., & Nichol, A. (2021). Diffusion Models Beat GANs on Image Synthesis. Advances in Neural Information Processing Systems, 34, 8780-8794. arXiv:2105.05233
- Ho, J., & Salimans, T. (2022). Classifier-Free Diffusion Guidance. arXiv:2207.12598. (단축본: NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications)
- Nichol, A., Dhariwal, P., Ramesh, A., Shyam, P., Mishkin, P., McGrew, B., Sutskever, I., & Chen, M. (2022). GLIDE: Towards Photorealistic Image Generation and Editing with Text-Guided Diffusion Models. Proceedings of the 39th International Conference on Machine Learning (ICML), PMLR 162, 16784-16804. arXiv:2112.10741
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., & Poole, B. (2021). Score-Based Generative Modeling through Stochastic Differential Equations. International Conference on Learning Representations (ICLR). arXiv:2011.13456
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. Advances in Neural Information Processing Systems, 33, 6840-6851. arXiv:2006.11239
'인공지능 논문 정리 > Diffusiion' 카테고리의 다른 글
| [Diffusion 10] OT에서 Flow Matching으로: Rectified Flow와 Schrödinger Bridge (0) | 2026.06.13 |
|---|---|
| [Diffusion 9] Optimal Transport 입문: Wasserstein 거리와 최적 경로 (0) | 2026.06.12 |
| [Diffusion 7] 연속 시간으로의 확장: SDE와 ODE 관점에서 본 Diffusion (0) | 2026.06.07 |
| [Diffusion 6] Score Function이란 무엇인가: Score Matching에 대한 이해 (2) | 2026.01.20 |
| [Diffusion 5] DDPM 논문 완전 정복 (하): Reverse Process와 학습 (0) | 2026.01.19 |


