A new set of inequalities is introduced, based on a novel but natural interpolation between Borel probability measures on $\mathbb{R}^d$.
McCann, A Convexity Principle for Interacting Gases (1997)
Part 1부터 Part 3까지 우리는 Diffusion Model을 하나의 일관된 언어로 이해해 왔습니다. 데이터에 노이즈를 더하는 Forward Process, 그것을 되돌리는 Reverse Process, 그 역전을 가능케 하는 Score Function $\nabla_x \log p_t(x)$, 그리고 이 모든 것을 연속 시간에서 통합하는 SDE와 ODE까지 이것은 본질적으로 확률 과정(stochastic process)의 언어였습니다. 8장의 마지막에서 예고했듯이, 이번 장부터 시작하는 Part 4에서는 완전히 다른 각도에서 생성 모델을 바라봅니다. 그 출발점은 놀랍게도 1781년, 프랑스의 기하학자 가스파르 몽주(Gaspard Monge)가 던진 지극히 실용적인 질문입니다. "흙더미를 다른 곳으로 옮기는 가장 경제적인 방법은 무엇인가?"
이 질문이 생성 모델과 무슨 상관이 있을까요? 생성 모델의 임무를 한 문장으로 요약하면 "단순한 분포(가우시안 노이즈)를 복잡한 분포(데이터)로 변환하는 것"입니다. 노이즈의 확률 질량을 데이터의 확률 질량으로 옮기는 것이지요. 그렇다면 자연스럽게 다음 질문이 따라옵니다. 그 많은 변환 방법 중에서 가장 효율적인 것은 무엇인가? Diffusion이 택한 경로는 과연 최적인가? 이 질문에 답하는 수학이 바로 Optimal Transport (최적 수송, OT)이며, 그 답은 10장에서 다룰 Flow Matching과 Rectified Flow의 이론적 토대가 됩니다.
9.1 왜 Optimal Transport인가: 분포를 비교하는 두 가지 방식
9.1.1 생성 모델은 분포를 옮기는 기계다
지금까지의 여정을 거리를 두고 바라보면, 모든 생성 모델은 공통의 구조를 가집니다. 다루기 쉬운 사전 분포 $p_{\mathrm{prior}}$(대개 표준 가우시안)에서 출발하여, 어떤 변환을 거쳐 데이터 분포 $p_{\mathrm{data}}$에 도달하는 것입니다. VAE는 디코더라는 한 번의 사상으로, Normalizing Flow는 가역 함수의 합성으로, Diffusion은 수백~수천 단계의 점진적 노이즈 제거로 이 변환을 수행합니다. 변환의 형태는 제각각이지만 임무는 동일합니다. 확률 질량을 한 분포에서 다른 분포로 옮기는 것입니다.
이렇게 보면 두 가지 근본적인 질문이 떠오릅니다. 첫째, 두 분포가 얼마나 "가까운지"를 어떻게 측정할 것인가? 학습 목표를 세우려면 모델 분포와 데이터 분포 사이의 거리가 필요합니다. 둘째, 한 분포에서 다른 분포로 가는 수많은 경로 중 어떤 것이 "좋은" 경로인가? 같은 출발점과 도착점을 잇더라도 경로의 모양에 따라 샘플링 효율이 크게 달라질 수 있기 때문입니다. Optimal Transport는 이 두 질문에 동시에 답하는 이론입니다.
9.1.2 KL Divergence의 맹점: 수직 비교
우리가 지금까지 가장 많이 사용한 분포 간 비교 도구는 KL Divergence였습니다. 5장의 변분 하한도, 6장의 Score Matching도 결국 KL 또는 그 변형을 최소화하는 문제였습니다. KL Divergence의 정의를 다시 봅시다.
$$ D_{\mathrm{KL}}(p \,\|\, q) = \int p(x) \log \frac{p(x)}{q(x)} \, dx $$
이 식의 구조를 잘 보면, 같은 위치 $x$에서의 밀도 비율 $p(x)/q(x)$만을 평가합니다. 즉 KL은 각 지점에서 두 분포를 수직으로(vertically) 비교할 뿐, 확률 질량이 공간상에서 얼마나 멀리 떨어져 있는지는 전혀 고려하지 않습니다. 이 맹점은 두 분포의 support가 겹치지 않을 때 극명하게 드러납니다.
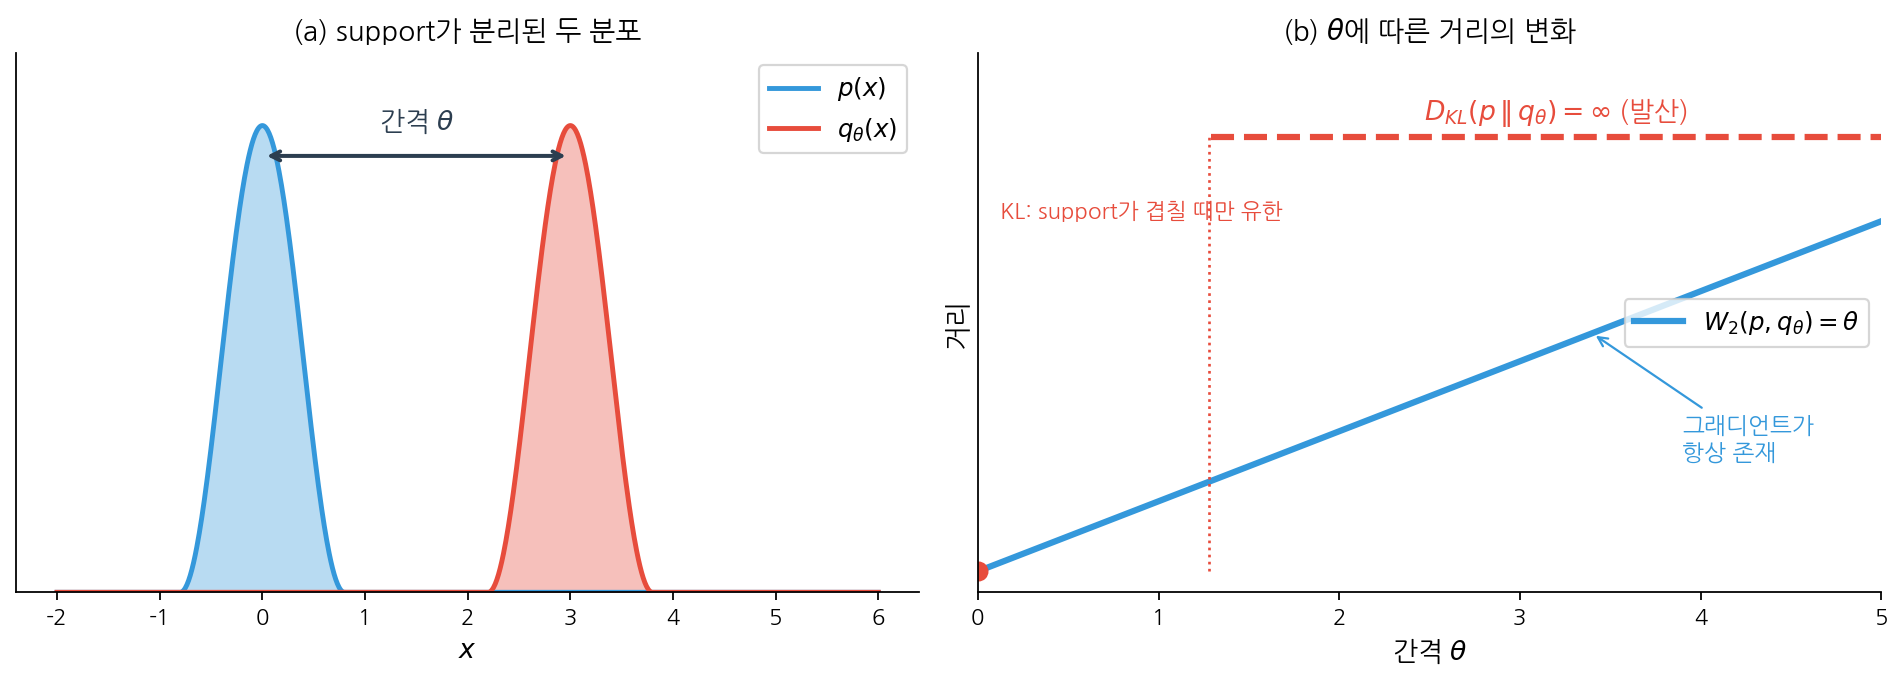
간단한 예로, 1차원에서 위치 $\theta$에 집중된 디랙 델타 분포 $\delta_\theta$와 원점의 델타 분포 $\delta_0$를 생각해 봅시다. $\theta \neq 0$이면 두 분포의 support는 전혀 겹치지 않으므로 $D_{\mathrm{KL}}(\delta_0 \,\|\, \delta_\theta) = \infty$입니다. 그리고 이 값은 $\theta = 0.001$이든 $\theta = 1000$이든 똑같이 무한대입니다. 두 분포가 "거의 같은" 경우와 "완전히 다른" 경우를 KL은 구별하지 못하는 것입니다. 미분 가능성은 더 절망적입니다. $\theta$를 아무리 조금 움직여도 KL 값은 변하지 않거나 무한대이므로, $\theta$에 대한 그래디언트가 유용한 학습 신호를 제공하지 못합니다.
9.1.3 수송 비용이라는 대안: 수평 비교
Optimal Transport는 정확히 반대의 관점을 취합니다. "분포 $\mu$의 질량을 분포 $\nu$의 모양으로 재배치하려면 질량을 얼마나 멀리 옮겨야 하는가?"라고 묻는 것입니다. 이것은 확률 질량의 공간적 이동 거리를 측정하는 수평(horizontal) 비교입니다. 위의 델타 분포 예시에서, $\delta_0$를 $\delta_\theta$로 옮기는 비용은 명백히 "질량 1을 거리 $|\theta|$만큼 옮기는 비용"이고, 따라서 거리가 $|\theta|$에 비례하여 부드럽게 변합니다. $\theta$가 가까우면 거리도 작고, $\theta$에 대한 그래디언트도 잘 정의됩니다. 이 차이는 그림 9.2에서 시각적으로 확인할 것입니다.
9.2 Monge 문제: 흙 옮기기의 수학 (1781)
9.2.1 문제의 탄생
1781년, 가스파르 몽주는 파리 왕립과학아카데미에 「Mémoire sur la théorie des déblais et des remblais」(절토와 성토 이론에 관한 논고)라는 논문을 발표합니다. 요새 건설에 관여하던 그가 마주한 문제는 다음과 같았습니다. 어떤 곳에서는 흙을 파내야 하고(déblais, 절토), 어떤 곳에는 흙을 쌓아야 한다(remblais, 성토). 흙을 운반하는 비용은 질량과 이동 거리에 비례한다. 그렇다면 어느 곳의 흙을 어느 곳으로 보내야 총비용이 최소가 되는가? 240여 년이 지난 지금도 Optimal Transport의 모든 교과서가 이 "흙 옮기기" 비유로 시작하며, Wasserstein 거리의 별칭인 Earth Mover's Distance(흙 운반자의 거리)에도 그 흔적이 남아 있습니다.
9.2.2 현대적 정식화: 수송 사상과 Push-forward
이 문제를 현대 확률론의 언어로 옮겨 봅시다. 파낼 흙의 분포를 확률 측도 $\mu$, 쌓을 흙의 분포를 확률 측도 $\nu$라고 합니다(전체 질량은 1로 정규화합니다). 흙을 옮기는 방법은 함수 $T: \mathcal{X} \to \mathcal{Y}$로 표현합니다. 위치 $x$에 있던 흙을 위치 $T(x)$로 보낸다는 뜻입니다. 이때 $T$가 "$\mu$를 $\nu$로 옮긴다"는 조건은 push-forward(밀어내기) 연산으로 정확하게 표현됩니다.
$$ T_{\#}\mu = \nu \quad \Longleftrightarrow \quad \nu(B) = \mu\big(T^{-1}(B)\big) \;\; \text{모든 가측집합 } B \text{에 대해} $$
풀어서 말하면, 도착지의 임의 영역 $B$에 쌓이는 흙의 양 $\nu(B)$는, $T$에 의해 $B$로 보내지는 출발지 영역 $T^{-1}(B)$에 있던 흙의 양과 정확히 같아야 한다는 뜻입니다. 질량은 창조되지도 소멸되지도 않습니다. 이 제약을 만족하는 $T$를 수송 사상(transport map)이라고 부릅니다. 한 위치에서 다른 위치로 단위 질량을 옮기는 비용을 함수 $c(x, y)$로 주면(몽주는 $c(x,y) = |x - y|$를 사용했습니다), Monge 문제는 다음의 최적화 문제가 됩니다.
$$ \inf_{T \,:\, T_{\#}\mu = \nu} \int_{\mathcal{X}} c\big(x, T(x)\big) \, d\mu(x) $$
9.2.3 Monge 문제의 세 가지 어려움
형태는 단순하지만, 이 문제는 수학적으로 대단히 다루기 어렵습니다. 실제로 엄밀한 일반 해법이 나오기까지 200년 이상이 걸렸습니다. 어려움의 원인은 세 가지입니다.
첫째, 질량 분할이 불가능합니다. $T$는 함수이므로 한 위치 $x$의 흙은 통째로 단 하나의 목적지 $T(x)$로 가야 합니다. 그런데 출발 분포가 한 점에 몰려 있고($\mu = \delta_{x_0}$) 도착 분포가 두 점으로 나뉘어 있다면($\nu = \frac{1}{2}\delta_{y_1} + \frac{1}{2}\delta_{y_2}$), 질량을 반씩 쪼개 보내야 하므로 조건을 만족하는 수송 사상 $T$ 자체가 존재하지 않습니다.
둘째, 제약 조건 $T_{\#}\mu = \nu$가 $T$에 대해 심하게 비선형입니다. 밀도가 존재하는 경우 이 제약은 야코비안이 포함된 치환적분 조건 $\rho_\mu(x) = \rho_\nu(T(x)) \, |\det \nabla T(x)|$이 되는데, 행렬식의 비선형성 때문에 표준적인 변분법을 적용하기 어렵습니다.
셋째, 문제가 볼록 (Convex) 하지 않습니다. 두 수송 사상의 평균은 일반적으로 수송 사상이 아니므로, 최적해의 존재성과 유일성을 보장하는 일반적 도구를 쓸 수 없습니다.
9.3 Kantorovich 완화: 사상에서 계획으로 (1942)
9.3.1 발상의 전환: 결합 분포로서의 수송
돌파구는 1942년, 소련의 수학자 레오니트 칸토로비치(Leonid Kantorovich)에게서 나왔습니다. 전시 자원 배분 문제를 연구하던 그는 「On the Translocation of Masses」라는 짧은 논문에서 Monge 문제를 근본적으로 다시 정식화했습니다(칸토로비치는 이 계열의 업적으로 1975년 노벨 경제학상을 수상합니다). 핵심 아이디어는 이렇습니다. "각 흙이 어디로 가는가"(사상)를 찾는 대신, "어디에서 어디로 얼마만큼의 흙이 흐르는가"(계획)를 찾자.
수학적으로, 수송 계획은 곱공간 $\mathcal{X} \times \mathcal{Y}$ 위의 결합 확률 측도 $\pi(x, y)$입니다. $\pi(A \times B)$는 "영역 $A$에서 영역 $B$로 옮겨지는 질량"을 뜻합니다. 이 계획이 출발 분포 $\mu$와 도착 분포 $\nu$에 부합하려면 주변 분포(marginal)가 맞아야 합니다.
$$ \Pi(\mu, \nu) = \Big\{ \pi \in \mathcal{P}(\mathcal{X} \times \mathcal{Y}) \;\Big|\; \pi(A \times \mathcal{Y}) = \mu(A), \;\; \pi(\mathcal{X} \times B) = \nu(B) \Big\} $$
이 집합 $\Pi(\mu, \nu)$의 원소를 $\mu$와 $\nu$의 커플링(coupling)이라고 부릅니다. 3장에서 배운 용어로 말하면, 주변 분포가 각각 $\mu$와 $\nu$로 고정된 결합 분포들의 집합입니다. Kantorovich 문제는 이 커플링들 중에서 평균 수송 비용을 최소화하는 것입니다.
$$ \mathcal{K}(\mu, \nu) = \inf_{\pi \in \Pi(\mu, \nu)} \int_{\mathcal{X} \times \mathcal{Y}} c(x, y) \, d\pi(x, y) $$
9.3.2 완화가 해결하는 것들
이 한 번의 발상 전환으로 Monge 문제의 세 가지 어려움이 모두 해소됩니다.
첫째, 질량 분할이 허용됩니다. $\pi$는 한 위치 $x$의 질량을 여러 목적지로 나누어 보낼 수 있습니다. 조건부 분포 $\pi(y \mid x)$가 퍼져 있는 것을 허용하기 때문입니다. 앞의 델타 분포 예시에서도 $\pi = \frac{1}{2}\delta_{(x_0, y_1)} + \frac{1}{2}\delta_{(x_0, y_2)}$라는 계획이 잘 정의됩니다.
둘째, 문제가 선형이 됩니다. 목적 함수 $\int c \, d\pi$는 $\pi$에 대해 선형이고, 제약 조건(주변 분포 일치)도 선형입니다. 즉 Kantorovich 문제는 무한 차원 선형 계획(linear programming)입니다.
셋째, 해가 항상 존재합니다. 제약 집합 $\Pi(\mu, \nu)$는 볼록하고, 독립 커플링 $\mu \otimes \nu$를 항상 포함하므로 공집합이 아니며, 적절한 조건에서 콤팩트합니다. 따라서 표준적인 논증으로 최소자의 존재가 보장됩니다.
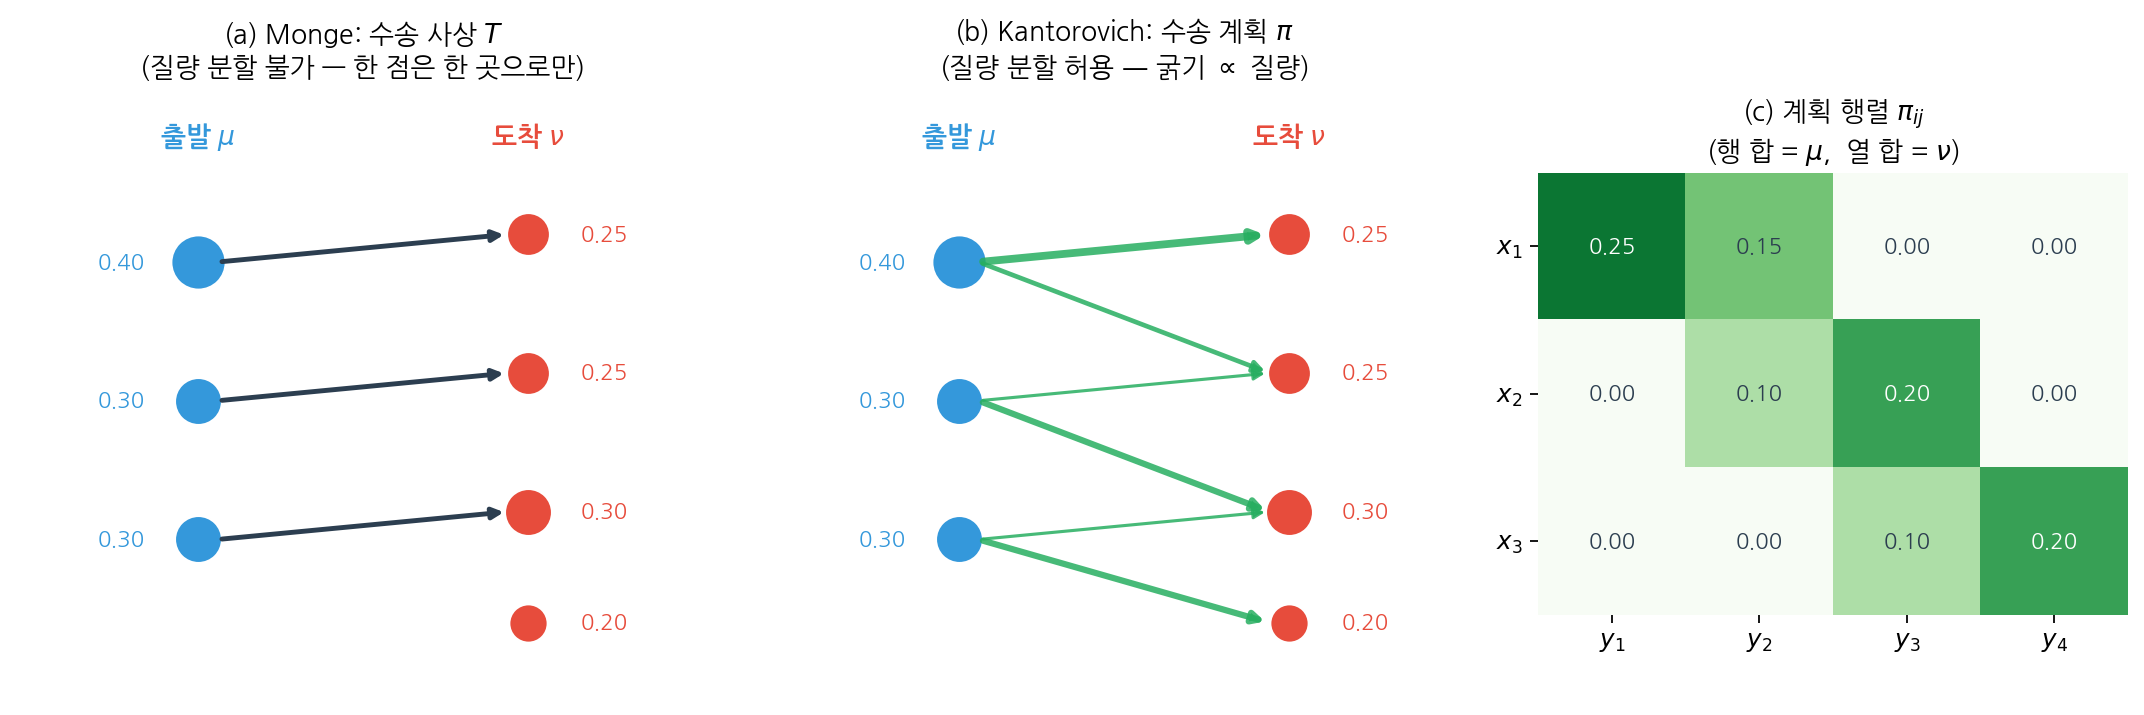
그림 9.1은 두 정식화의 차이를 보여 줍니다. Monge의 수송 사상은 각 출발점을 정확히 하나의 도착점에 연결하는 반면, Kantorovich의 수송 계획은 하나의 출발점에서 여러 도착점으로 질량을 나누어 보낼 수 있습니다. 중요한 사실은, 수송 사상 $T$가 존재하는 경우 그것은 $\pi_T = (\mathrm{id}, T)_{\#}\mu$라는 특수한 계획("그래프 위에 집중된" 계획)으로 표현되므로, Kantorovich 문제는 항상 Monge 문제의 하한이 된다는 점입니다. 그리고 9.5절의 Brenier 정리는, 좋은 조건에서는 두 문제의 답이 일치한다는 것을 보여 줍니다.
9.3.3 쌍대성: 가격의 언어
선형 계획이 된 덕분에 Kantorovich 문제는 아름다운 쌍대 문제(dual problem)를 가집니다. 직관은 경제학적입니다. 흙을 직접 옮기는 대신, 운송업자가 출발지에서 흙을 사고($\varphi(x)$의 가격) 도착지에서 되파는($\psi(y)$의 가격) 상황을 상상해 봅시다. 업주 입장에서 이 외주가 직접 운송보다 손해가 아니려면 모든 경로에 대해 $\varphi(x) + \psi(y) \le c(x, y)$여야 합니다. 운송업자는 이 제약 아래에서 총수익을 최대화합니다.
$$ \mathcal{K}(\mu, \nu) = \sup_{\varphi(x) + \psi(y) \,\le\, c(x, y)} \left[ \int_{\mathcal{X}} \varphi \, d\mu + \int_{\mathcal{Y}} \psi \, d\nu \right] $$
이것이 Kantorovich 쌍대성입니다. 적절한 조건에서 원문제와 쌍대 문제의 최적값은 일치하며, 최적 쌍대 변수 $\varphi$를 Kantorovich 포텐셜이라고 부릅니다. 이 포텐셜은 잠시 후 Brenier 정리에서 최적 수송 사상을 만들어 내는 핵심 재료가 됩니다. 또한 비용이 $c(x,y) = \|x - y\|$일 때 쌍대 문제는 1-Lipschitz 함수에 대한 최대화 $\sup_{\|f\|_{\mathrm{Lip}} \le 1} \mathbb{E}_\mu[f] - \mathbb{E}_\nu[f]$로 단순화되는데, 이 형태가 바로 Wasserstein GAN의 판별자 학습 목표입니다. OT의 쌍대성이 딥러닝에 직접 응용된 대표적 사례입니다.
9.4 Wasserstein 거리: 분포 공간의 기하학
9.4.1 정의와 거리 공리
이제 비용 함수를 거리의 거듭제곱 $c(x, y) = \|x - y\|^p$ ($p \ge 1$)로 특정하면, Kantorovich 문제의 최적값으로부터 분포 사이의 거리가 정의됩니다.
$$ W_p(\mu, \nu) = \left( \inf_{\pi \in \Pi(\mu, \nu)} \int \|x - y\|^p \, d\pi(x, y) \right)^{1/p} $$
이것이 Wasserstein-$p$ 거리입니다. 이름과 달리 실질적 기원은 Monge와 Kantorovich에 있지만, 관례를 따라 Wasserstein 거리라고 부르겠습니다. 이 양은 이름값을 합니다. 즉 $p$차 모멘트가 유한한 확률 측도들의 공간 $\mathcal{P}_p(\mathbb{R}^d)$ 위에서 거리 공리인 비음성(>=0)과 식별성($W_p(\mu,\nu)=0 \Leftrightarrow \mu=\nu$), 대칭성, 삼각 부등식를 모두 만족하는 진짜 거리 함수(metric)입니다. KL Divergence가 대칭성도 삼각 부등식도 만족하지 못하는 것과 대조적입니다.
9.4.2 손에 잡히는 예시들
몇 가지 계산 가능한 사례로 감각을 잡아 봅시다. 가장 단순한 예는 9.1절의 두 델타 분포입니다. $\delta_{x_0}$에서 $\delta_{y_0}$로 가는 커플링은 모든 질량을 $x_0$에서 $y_0$로 보내는 것 하나뿐이므로,
$$ W_p(\delta_{x_0}, \delta_{y_0}) = \|x_0 - y_0\| $$
입니다. 거리가 두 점 사이의 유클리드 거리로 부드럽게 변합니다. KL이라면 $x_0 \neq y_0$인 순간 무한대로 발산했을 것입니다. 그림 9.2는 support가 겹치지 않는 두 분포에 대해 KL과 Wasserstein 거리가 어떻게 다르게 행동하는지를 보여 줍니다. 분포 사이의 간격 $\theta$가 변할 때 Wasserstein 거리는 $\theta$에 선형으로 반응하여 유용한 그래디언트를 제공하지만, KL은 거의 모든 곳에서 포화되어 학습 신호를 주지 못합니다.
두 번째 예는 가우시안입니다. 1차원 가우시안 $\mu = \mathcal{N}(m_1, \sigma_1^2)$, $\nu = \mathcal{N}(m_2, \sigma_2^2)$ 사이의 Wasserstein-2 거리는 닫힌 형태로 계산됩니다.
$$ W_2^2(\mu, \nu) = (m_1 - m_2)^2 + (\sigma_1 - \sigma_2)^2 $$
평균의 차이와 표준편차의 차이가 피타고라스식으로 결합하는, 직관에 완벽히 부합하는 결과입니다. 다차원 가우시안에서도 평균 항 $\|m_1 - m_2\|^2$에 공분산 행렬 사이의 (Bures 거리라 불리는) 항이 더해진 닫힌 형태가 존재하며, 이는 생성 모델 평가에 널리 쓰이는 FID(Fréchet Inception Distance)의 수학적 정체이기도 합니다. FID는 두 이미지 분포를 특징 공간에서 가우시안으로 근사한 뒤 그 사이의 $W_2$를 계산하는 지표입니다.
9.4.3 왜 하필 $W_2$인가
앞으로 우리는 거의 항상 $p = 2$, 즉 이차 비용 $c(x,y) = \|x-y\|^2$의 Wasserstein-2 거리를 사용합니다. 여기에는 분명한 이유가 있습니다. 첫째, 이차 비용에서만 성립하는 Brenier 정리(9.5절)가 최적 수송에 미분 가능한 구조를 부여합니다. 둘째, $W_2$가 만드는 기하학에서 분포 사이의 측지선이 간단한 직선 보간으로 주어지며(9.6절), 이것이 Flow Matching의 직선 경로로 이어집니다. 셋째, $W_2$ 공간은 리만 기하학적 구조를 가져서, 분포 공간 위의 "그래디언트 흐름"이라는 강력한 관점을 가능하게 합니다. 비유하자면 $W_2$는 분포들의 공간을 단순한 집합이 아니라, 거리와 각도와 최단 경로가 있는 구부러진 공간으로 만들어 줍니다.
9.5 Brenier 정리: 최적 수송 사상의 존재 (1991)
9.5.1 두 문제의 재회
Kantorovich 완화는 해의 존재를 보장해 주었지만, 한 가지 찜찜함이 남습니다. 우리가 얻는 것은 확률적인 "계획" $\pi$인데, 생성 모델이 정말 원하는 것은 노이즈 $x$를 받아 데이터 $T(x)$를 내놓는 결정론적 "사상" $T$입니다. 완화된 문제의 최적해가 사실은 사상의 형태를 가질 수는 없을까요? 1991년 얀 브르니에(Yann Brenier)가 이 질문에 결정적인 답을 주었습니다. Monge 문제에 대한 최초의 엄밀한 일반 해로 평가받는 결과입니다.
이 정리는 여러 겹의 의미를 가집니다. 우선 좋은 조건에서 Monge 문제와 Kantorovich 문제의 답이 일치함을 보여 줍니다. 완화는 답을 바꾸지 않고 풀 수 있는 형태로 만들어 준 것뿐입니다. 다음으로, 최적 사상이 아무 함수가 아니라 볼록 포텐셜의 그래디언트라는 강한 구조를 가짐을 알려 줍니다. 1차원에서 볼록 함수의 도함수는 단조증가 함수이므로, 최적 수송은 "질량의 순서를 섞지 않고" 옮깁니다. 왼쪽 질량은 왼쪽으로, 오른쪽 질량은 오른쪽으로 가서 수송 경로들이 서로 교차하지 않습니다. 고차원에서 $T = \nabla\varphi$ 조건은 이 비교차성의 자연스러운 일반화입니다.
9.5.2 친숙한 구조와의 연결
$T = \nabla \varphi$라는 형태가 낯설지 않게 느껴진다면, 6장에서 만난 Score Function $\nabla_x \log p(x)$ 역시 스칼라 함수의 그래디언트장이었음을 떠올려 보시기 바랍니다. 분포를 다루는 핵심 객체들이 반복해서 "포텐셜의 그래디언트"로 나타나는 것은 우연이 아니며, 그래디언트장은 회전 성분이 없어 질량을 가장 낭비 없이 운반하는 벡터장이기 때문입니다. 한편 push-forward 제약을 밀도로 쓰면 $\varphi$는 다음의 Monge–Ampère 방정식을 만족합니다.
$$ \det\big(\nabla^2 \varphi(x)\big) = \frac{\rho_\mu(x)}{\rho_\nu(\nabla \varphi(x))} $$
악명 높은 완전 비선형 편미분방정식입니다. 일반 차원에서 이 방정식을 직접 푸는 것은 매우 어렵고, 바로 이 계산적 어려움이 9.7절의 entropic regularization과 10장의 신경망 기반 접근(Flow Matching)이 등장하는 배경이 됩니다.
9.6 Displacement Interpolation: 분포 사이의 최적 경로
9.6.1 두 가지 보간법
지금까지는 두 분포 사이의 "거리"를 다루었습니다. 이제 이 장의 부제이자 Diffusion과의 연결 고리인 "경로"로 넘어갑니다. 질문은 이렇습니다. 분포 $\mu_0$에서 분포 $\mu_1$로 연속적으로 변형해 가는 가장 자연스러운 경로 $(\mu_t)_{t \in [0,1]}$는 무엇인가?
가장 먼저 떠오르는 답은 밀도의 선형 보간, 즉 혼합 보간(mixture interpolation)일 것입니다.
$$ \mu_t^{\mathrm{mix}} = (1 - t)\,\mu_0 + t\,\mu_1 $$
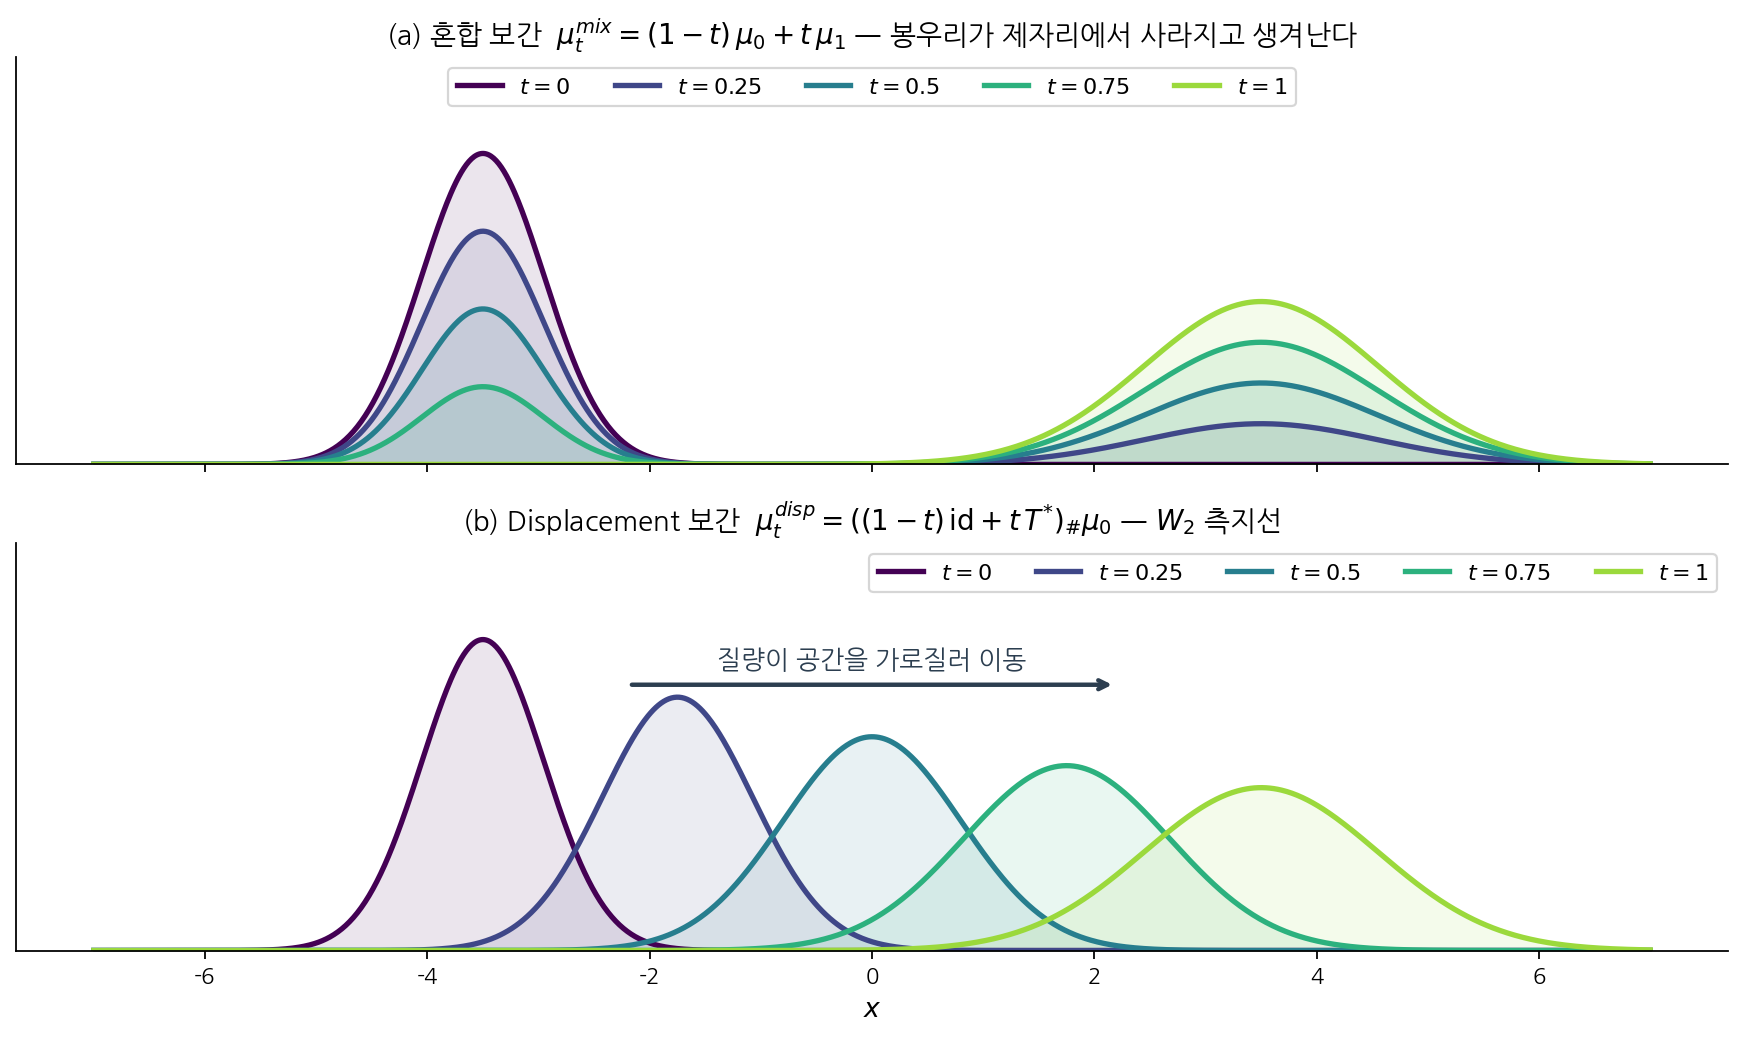
그러나 이 보간은 직관과 전혀 다르게 행동합니다. $\mu_0$이 왼쪽의 종 모양, $\mu_1$이 오른쪽의 종 모양이라면, $\mu_t^{\mathrm{mix}}$는 왼쪽 봉우리가 제자리에서 가라앉으면서 오른쪽 봉우리가 제자리에서 솟아오르는, 내내 두 개의 봉우리를 가진 분포입니다. 질량이 공간을 가로질러 이동하는 것이 아니라, 한쪽에서 증발해 다른 쪽에서 응결하는 셈입니다. 이것은 KL의 "수직 비교"가 경로의 형태로 나타난 것이라 할 수 있습니다.
Optimal Transport가 제안하는 답은 다릅니다. 최적 수송 사상 $T^*$를 따라 각 질량 입자를 출발점에서 도착점까지 등속 직선 운동시키는 것입니다. 1997년 로버트 매캔(Robert McCann)이 도입한 displacement interpolation(변위 보간)입니다.
$$ \mu_t^{\mathrm{disp}} = \big( (1 - t)\,\mathrm{id} + t\, T^{*} \big)_{\#}\, \mu_0 $$
위치 $x$의 입자가 시각 $t$에 $(1-t)x + t\,T^*(x)$에 있도록 모든 입자를 동시에 움직였을 때 생기는 분포들의 행렬입니다. 같은 두 종 모양 분포에 대해 $\mu_t^{\mathrm{disp}}$는 하나의 봉우리가 통째로 미끄러져 이동하는 모습이 됩니다. 그림 9.3이 두 보간의 차이를 보여 줍니다. 이 장의 도입부에 인용한 McCann의 문장에서 "novel but natural interpolation"이 가리키는 것이 바로 이것입니다.
Displacement interpolation은 단순히 보기 좋은 경로가 아니라, $W_2$ 거리가 만드는 기하학에서의 측지선(geodesic), 즉 최단 경로입니다. 실제로 이 경로 위에서는 다음이 성립합니다.
$$ W_2(\mu_s, \mu_t) = |t - s| \cdot W_2(\mu_0, \mu_1), \qquad 0 \le s, t \le 1 $$
경로를 따라 잰 거리가 정확히 비례적으로 늘어나는, 등속 직선 운동의 분포 공간 버전입니다. McCann은 한 걸음 더 나아가, 엔트로피나 포텐셜 에너지 같은 중요한 범함수들이 이 경로를 따라 볼록해진다는 displacement convexity를 보였습니다. 일반 선형 보간에서는 성립하지 않는 볼록성이 올바른 기하학을 선택하는 순간 복원된다는, 이후 OT 이론 전체를 떠받치는 발견입니다.
9.6.2 Benamou–Brenier 공식: 정적 문제의 동역학적 표현
Displacement interpolation은 "최적 경로"를 답으로 주었지만, 2000년 브누아무(Jean-David Benamou)와 브르니에는 거꾸로 경로에 대한 최적화로 $W_2$ 자체를 정의할 수 있음을 보였습니다. 분포의 시간 변화 $\rho_t$와 그것을 실어 나르는 속도장 $v_t$를 함께 최적화하는 것입니다.
$$ W_2^2(\mu_0, \mu_1) = \min_{(\rho_t,\, v_t)} \int_0^1 \!\! \int_{\mathbb{R}^d} \|v_t(x)\|^2 \, \rho_t(x) \, dx \, dt $$
단, $(\rho_t, v_t)$는 경계 조건 $\rho_0 = \mu_0$, $\rho_1 = \mu_1$과 함께 질량 보존을 나타내는 연속 방정식(continuity equation)을 만족해야 합니다.
$$ \frac{\partial \rho_t}{\partial t} + \nabla \cdot (\rho_t \, v_t) = 0 $$
목적 함수는 흐르는 질량의 총 운동 에너지입니다. 즉 Benamou–Brenier 공식은 "$W_2$ 거리란 한 분포를 다른 분포로 운반하는 데 필요한 최소 운동 에너지"라고 말합니다. 그리고 그 최솟값을 달성하는 흐름이 정확히 displacement interpolation이며, 최적 속도장은 시간을 따라 입자를 등속 직선으로 모는 장입니다.
이 공식이 중요한 이유는 우리에게 매우 친숙한 구조이기 때문입니다. 7장에서 본 Probability Flow ODE는 속도장 $v_t$가 모는 결정론적 흐름 $dx = v_t(x)\,dt$였고, 그 분포의 진화 역시 연속 방정식을 따랐습니다. 즉 Diffusion의 ODE 관점과 Benamou–Brenier의 동역학적 OT는 같은 무대 위에 서 있습니다. 둘 다 "속도장이 분포를 운반하는" 그림이며, 차이는 단 하나, 그 속도장이 만드는 경로가 최적인가 아닌가 입니다. 이 관찰이 다음 절과 10장의 출발점입니다.
9.6.3 직선 경로 대 곡선 경로: Diffusion은 최적인가
이제 이 장의 질문으로 돌아갑니다. Diffusion Model이 노이즈에서 데이터로 가는 경로는 OT의 관점에서 어떤 경로일까요? 4장에서 유도한 Forward Process의 닫힌 형태를 떠올려 봅시다.
$$ x_t = \sqrt{\bar{\alpha}_t}\, x_0 + \sqrt{1 - \bar{\alpha}_t}\,\epsilon $$
개별 샘플 $x_0$와 노이즈 $\epsilon$을 잇는 이 경로는 계수가 $\sqrt{\bar{\alpha}_t}$와 $\sqrt{1-\bar{\alpha}_t}$로 비선형적으로 변하는 곡선입니다. 두 계수의 제곱합이 1로 묶여 있으므로, 기하학적으로는 직선이 아니라 원호에 가까운 궤적을 그립니다. 더구나 Reverse SDE로 샘플링할 때는 매 단계 노이즈가 주입되어 실제 궤적은 더욱 구불구불해집니다. 반면 같은 양 끝 분포에 대한 OT의 displacement 경로는 모든 입자가 직선으로, 등속으로 움직입니다. 그림 9.4는 두 경로의 차이를 보여 줍니다.
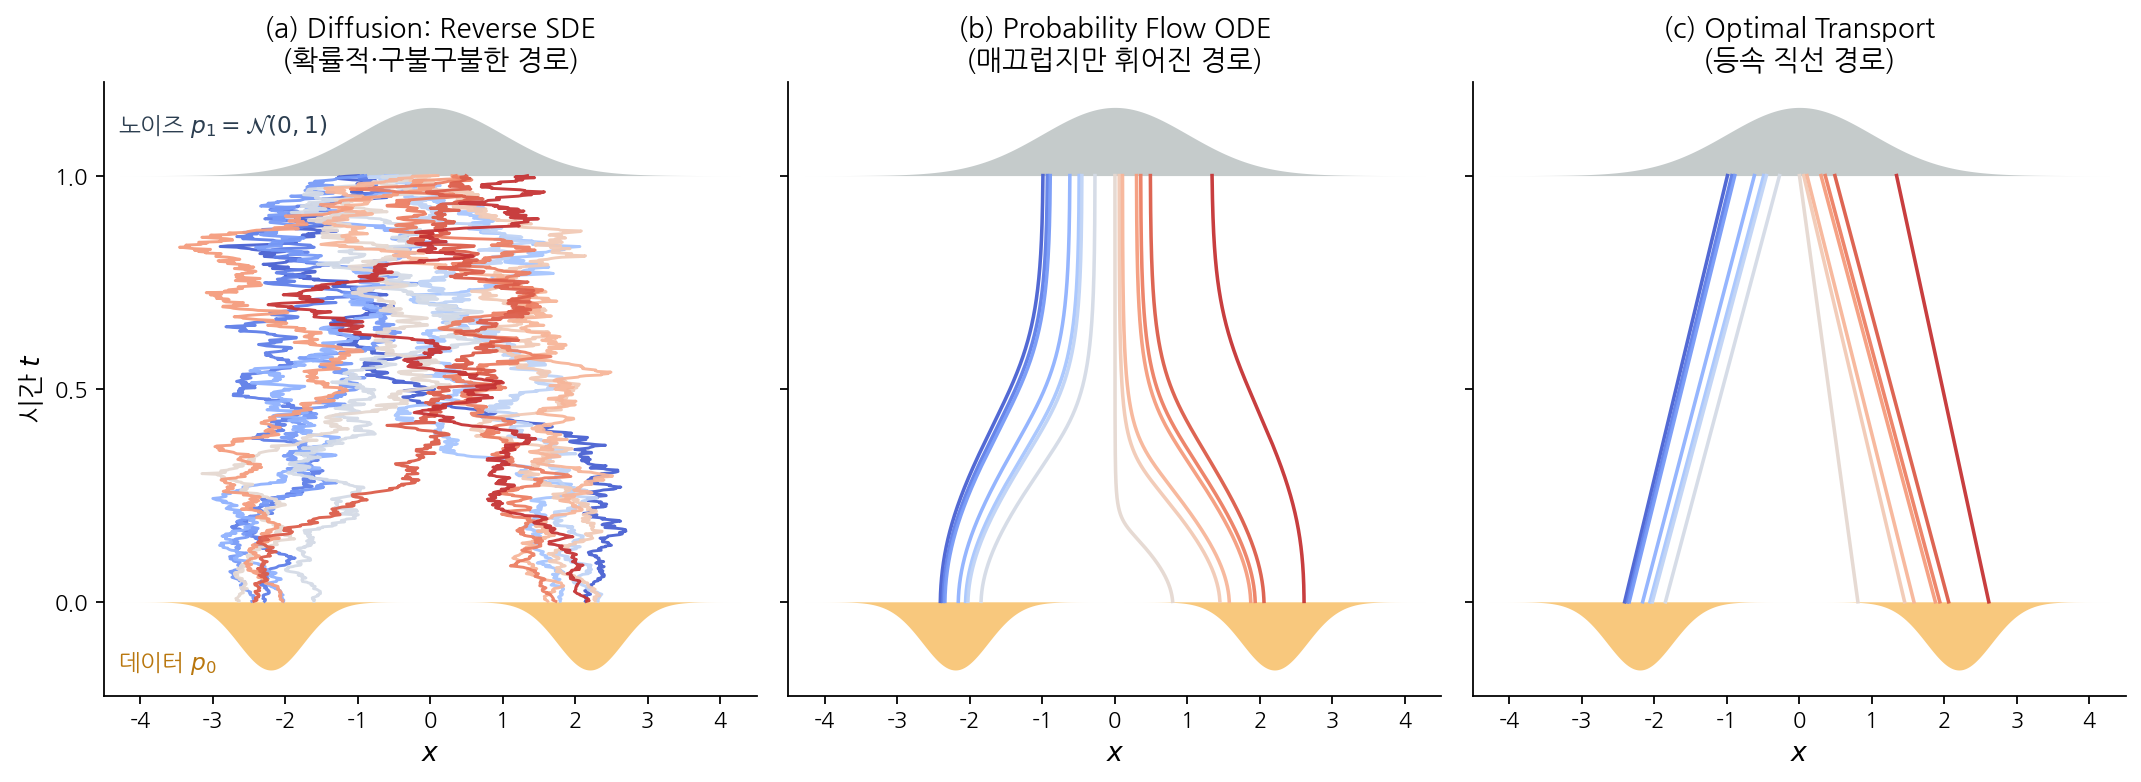
경로의 모양이 왜 중요할까요? 답은 샘플링 비용에 있습니다. 7장에서 보았듯 샘플 생성은 결국 ODE/SDE의 수치 적분이고, 수치 적분의 오차는 경로의 곡률에 비례하여 쌓입니다. 속도장이 직선 등속 운동을 만든다면 극단적으로는 단 한 번의 오일러 스텝 $x_1 = x_0 + v(x_0)$만으로 적분이 정확해집니다. DDPM이 수백 단계를 필요로 했던 근본적 이유 중 하나가 경로의 곡률이었던 셈이며, "경로를 직선으로 펴자"는 아이디어가 10장에서 다룰 Rectified Flow의 핵심 동기가 됩니다.
9.7 Entropic Regularization과 Sinkhorn 알고리즘
9.7.1 계산이라는 현실적 장벽
이론은 아름답지만, OT의 실제 계산은 만만치 않습니다. 각 $n$개의 점으로 이루어진 두 이산 분포 사이의 Kantorovich 문제는 $n \times n$ 변수의 선형 계획이고, 표준적인 솔버의 비용은 대략 $O(n^3 \log n)$ 수준으로 증가합니다. 데이터가 수만 개만 되어도 감당하기 어렵고, GPU 병렬화에도 적합하지 않습니다. 머신러닝 규모에서 OT를 쓰려면 다른 길이 필요합니다.
2013년 마르코 쿠튀리(Marco Cuturi)가 제시한 해법은 문제를 살짝 "뭉개는" 것입니다. Kantorovich 목적 함수에 수송 계획의 엔트로피를 정규화 항으로 추가합니다.
$$ \mathcal{K}_\varepsilon(\mu, \nu) = \min_{\pi \in \Pi(\mu, \nu)} \left[ \int c(x, y) \, d\pi(x, y) + \varepsilon \, D_{\mathrm{KL}}\big(\pi \,\|\, \mu \otimes \nu\big) \right] $$
$\varepsilon > 0$은 정규화 강도입니다. KL 항은 계획 $\pi$가 독립 커플링 $\mu \otimes \nu$에서 너무 멀어지는 것, 즉 너무 결정론적으로 날카로워지는 것을 벌점합니다. $\varepsilon \to 0$이면 원래 OT 문제를 회복하고, $\varepsilon$이 크면 계획이 점점 퍼져 흐릿해집니다. 중요한 것은 이 작은 수정이 가져오는 계산적 보상입니다. 목적 함수가 강볼록해져 해가 유일해지고, 최적해가 명시적인 형태를 갖게 됩니다.
9.7.2 Sinkhorn 반복
라그랑주 쌍대성을 적용하면, 이산 설정에서 entropic OT의 최적 계획이 다음 구조를 가짐을 보일 수 있습니다. 비용 행렬 $C_{ij} = c(x_i, y_j)$에 대해 깁스 핵 $K_{ij} = e^{-C_{ij}/\varepsilon}$을 정의하면,
$$ \pi^{*}_{ij} = u_i \, K_{ij} \, v_j $$
즉 최적 계획은 고정된 행렬 $K$를 양수 대각 행렬로 좌우에서 스케일링한 것입니다. 미지수는 두 벡터 $u, v$뿐이고, 이들은 주변 분포 제약(행의 합이 $a$, 열의 합이 $b$)으로 결정됩니다. 그리고 이 두 제약을 번갈아 맞추는 단순한 반복이 해로 수렴합니다.
$$ u \leftarrow \frac{a}{K v}, \qquad v \leftarrow \frac{b}{K^{\top} u} $$
(나눗셈은 성분별 연산입니다.) 이것이 Sinkhorn 알고리즘입니다. 행렬–벡터 곱 두 번이 반복의 전부이므로 GPU에서 대단히 빠르게 돌고, Cuturi의 표현을 빌리면 기존 솔버보다 수십~수백 배 빠른 "광속(lightspeed)" 계산이 가능해집니다. 이 논문을 기점으로 OT는 이론가의 도구에서 머신러닝의 일상적 도구로 변모했고, 도메인 적응, 생성 모델 평가, 단일세포 생물학 등 광범위한 응용이 뒤따랐습니다.
9.7.3 흐릿한 계획의 또 다른 얼굴
Entropic regularization을 단지 계산 트릭으로만 보면 절반만 보는 것입니다. $\varepsilon$이 만드는 "흐릿한" 수송 계획은 그 자체로 깊은 의미를 가집니다. 결정론적 최적 수송이 모든 입자를 정해진 직선으로 보내는 것이라면, entropic OT는 입자들이 약간의 무작위성을 가지고 출발지에서 도착지로 흘러가는 것에 해당합니다. 실제로 entropic OT는 "양 끝 분포가 고정된 브라운 운동 입자들의 가장 그럴듯한 경로 분포는 무엇인가"라는 1932년 슈뢰딩거(Erwin Schrödinger)의 질문인 Schrödinger Bridge 문제와 수학적으로 동등합니다. 무작위성의 세기가 $\varepsilon$에 대응합니다. 어디선가 본 그림이지 않습니까? 노이즈를 동반한 채 한 분포에서 다른 분포로 흘러가는 과정, 바로 Diffusion입니다. 이 연결의 정확한 내용은 10장에서 다룹니다.
9.8 요약 및 다음 장 예고
이번 장에서 우리는 Diffusion을 새로운 각도에서 조명하기 위한 기하학적 언어, Optimal Transport의 핵심을 구축했습니다.
Monge의 1781년 문제는 질량을 옮기는 최소 비용의 수송 사상 $T_{\#}\mu = \nu$를 찾는 것이었지만, 질량 분할 불가능성과 비선형 제약 때문에 일반적으로 풀기 어려웠습니다. Kantorovich는 1942년 사상을 커플링 $\pi \in \Pi(\mu,\nu)$로 완화하여 문제를 해가 보장되는 선형 계획으로 바꾸었고, 그 최적값이 분포 공간의 진정한 거리인 Wasserstein 거리 $W_p$를 정의합니다. Wasserstein 거리는 KL Divergence와 달리 질량의 공간적 이동을 측정하는 수평 비교이므로, support가 겹치지 않는 분포 사이에서도 부드러운 거리와 그래디언트를 제공합니다. Brenier의 1991년 정리는 이차 비용에서 최적 수송이 볼록 포텐셜의 그래디언트 $T^* = \nabla\varphi$라는 사상으로 주어짐을 보여 Monge와 Kantorovich를 다시 결합했습니다. McCann의 displacement interpolation $\mu_t = ((1-t)\,\mathrm{id} + tT^*)_{\#}\mu_0$는 $W_2$ 기하학의 측지선으로서 두 분포 사이의 최적 경로인 모든 입자의 등속 직선 운동을 제공하며, Benamou–Brenier 공식은 이를 "최소 운동 에너지의 흐름"이라는 동역학적 그림으로 완성합니다. 이 그림은 Diffusion의 Probability Flow ODE와 같은 형식을 공유하면서, Diffusion의 곡선 경로가 최적이 아님을, 따라서 더 적은 단계로 생성할 여지가 있음을 드러냅니다. 마지막으로 Cuturi의 entropic regularization과 Sinkhorn 알고리즘은 OT를 머신러닝 규모에서 계산 가능하게 만들었으며, 그 확률적 해석인 Schrödinger Bridge는 OT와 Diffusion을 잇는 다리가 됩니다.
참고문헌
- Monge, G. (1781). Mémoire sur la théorie des déblais et des remblais. Histoire de l'Académie Royale des Sciences de Paris, avec les Mémoires de Mathématique et de Physique pour la même année, 666-704.
- Kantorovich, L. V. (1942). On the Translocation of Masses. C.R. (Doklady) Acad. Sci. URSS (N.S.), 37, 199-201. (영역본: Management Science, 5(1), 1-4, 1958)
- Brenier, Y. (1991). Polar Factorization and Monotone Rearrangement of Vector-Valued Functions. Communications on Pure and Applied Mathematics, 44(4), 375-417.
- McCann, R. J. (1997). A Convexity Principle for Interacting Gases. Advances in Mathematics, 128(1), 153-179.
- Benamou, J.-D., & Brenier, Y. (2000). A Computational Fluid Mechanics Solution to the Monge-Kantorovich Mass Transfer Problem. Numerische Mathematik, 84(3), 375-393.
- Cuturi, M. (2013). Sinkhorn Distances: Lightspeed Computation of Optimal Transport. Advances in Neural Information Processing Systems, 26, 2292-2300. arXiv:1306.0895
- Villani, C. (2009). Optimal Transport: Old and New. Grundlehren der mathematischen Wissenschaften, Vol. 338. Springer, Berlin.
- Peyré, G., & Cuturi, M. (2019). Computational Optimal Transport: With Applications to Data Science. Foundations and Trends in Machine Learning, 11(5-6), 355-607.
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. Advances in Neural Information Processing Systems, 33, 6840-6851. arXiv:2006.11239
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., & Poole, B. (2021). Score-Based Generative Modeling through Stochastic Differential Equations. International Conference on Learning Representations. arXiv:2011.13456
'인공지능 논문 정리 > Diffusiion' 카테고리의 다른 글
| [Diffusion 11]. Diffusion의 통합적 이해: VAE, Normalizing Flow, 그리고 Score-based Model (1) | 2026.06.13 |
|---|---|
| [Diffusion 10] OT에서 Flow Matching으로: Rectified Flow와 Schrödinger Bridge (0) | 2026.06.13 |
| [Diffusion 8] Guidance의 수학: 조건부 생성을 가능케 하는 원리 (0) | 2026.06.11 |
| [Diffusion 7] 연속 시간으로의 확장: SDE와 ODE 관점에서 본 Diffusion (0) | 2026.06.07 |
| [Diffusion 6] Score Function이란 무엇인가: Score Matching에 대한 이해 (2) | 2026.01.20 |


