Diffusion models ... have both likelihood-based and score-based interpretations.
Calvin Luo, Understanding Diffusion Models: A Unified Perspective (2022)
열 개의 장을 지나오는 동안 우리는 같은 대상을 여러 각도에서 비추어 왔습니다. 1장과 2장에서 "파괴는 쉽고 복원은 어렵지만, 파괴의 과정을 알면 복원도 가능하다"는 직관을 잡았고, 3장에서 5장까지 DDPM의 변분 하한을 따라가며 노이즈 예측이라는 학습 목표를 끝까지 유도했습니다. 6장에서는 그 노이즈 예측이 Score Function $\nabla_x \log p(x)$의 추정과 동치임을 보았고, 7장에서 이산 마르코프 체인을 연속 시간 SDE와 그 결정론적 쌍둥이인 Probability Flow ODE로 일반화했습니다. 8장은 조건부 생성의 수학을, 그리고 9장과 10장의 Part 4는 Optimal Transport의 기하학과 Flow Matching·Rectified Flow·Schrödinger Bridge라는 현대적 패러다임을 다루었습니다.
이 여정에서 거듭 마주친 한 가지 사실이 있습니다. 겉보기에 전혀 다른 출발점에서 시작한 방법들이 자꾸만 같은 자리로 수렴한다는 것입니다. 변분 추론에서 출발한 DDPM, 에너지 함수의 그래디언트에서 출발한 Score Matching, 미분방정식에서 출발한 SDE/ODE, 최적 수송에서 출발한 Flow Matching, 이들은 서로 다른 언어로 같은 이야기를 하고 있었습니다. 이번 마지막 장의 목표는 이 우연이 아닌 일치를 정면으로 다루는 것입니다. 우리는 Diffusion을 생성 모델이라는 더 큰 지형 안에 놓고, 그 양옆에 선 두 고전적 거인인 Variational Autoencoder(VAE)와 Normalizing Flow(NF) 와의 관계를 정확한 수학으로 잇습니다. 그 과정에서 DDPM이 사실은 특수한 형태의 계층적 VAE이며(Luo, 2022), Probability Flow ODE가 사실은 하나의 Continuous Normalizing Flow임을 보게 될 것입니다. 마지막으로 Latent Diffusion과 Consistency Model처럼 이 패러다임들을 결합하고 증류하는 흐름을 짚으며, "모든 생성 모델은 서로 연결되어 있다"는 이 시리즈의 결론을 매듭짓겠습니다.
11.1 하나의 질문: 데이터 분포를 어떻게 배울 것인가
생성 모델링의 출발점은 단 하나의 질문입니다. 우리가 가진 것은 어떤 미지의 분포 $p_{\text{data}}(x)$에서 독립적으로 추출된 유한한 표본 $\{x^{(1)}, \dots, x^{(N)}\}$뿐일 때, 이 분포 자체를 어떻게 학습하여 새로운 표본을 생성할 수 있는가 하는 것입니다. 좋은 생성 모델은 보통 다음 세 가지 능력 중 일부 또는 전부를 갖추기를 요구받습니다.
- 샘플링(sampling): $p_\theta(x)$에서 새로운 $x$를 뽑을 수 있는가.
- 우도 평가(likelihood evaluation): 주어진 $x$에 대해 $p_\theta(x)$, 혹은 적어도 그 하한이나 근사를 계산할 수 있는가.
- 표현(representation): 데이터를 의미 있는 잠재 공간으로 인코딩할 수 있는가.
이 세 능력을 동시에, 그것도 효율적으로 만족시키는 것은 놀라울 만큼 어렵습니다. 직접적인 길은 모델 분포를 명시적으로 적어 두고 데이터의 로그 우도 $\sum_i \log p_\theta(x^{(i)})$를 최대화하는 것입니다. 그러나 표현력이 충분한 분포는 거의 항상 정규화 상수, 즉 $p_\theta(x) = \tilde{p}_\theta(x)/Z_\theta$의 $Z_\theta = \int \tilde{p}_\theta(x)\, dx$를 다루기 어렵게 만듭니다. 고차원 적분 $Z_\theta$는 일반적으로 계산 불가능합니다. 생성 모델의 여러 계열은 본질적으로 이 계산 불가능성을 어떻게 우회하는가에 대한 서로 다른 답입니다.
크게 보면 우도 기반(likelihood-based) 접근은 세 갈래로 나뉩니다. 첫째, VAE는 잠재 변수를 도입하고 계산 불가능한 우도 대신 그 변분 하한(ELBO)을 최대화합니다. 둘째, Normalizing Flow는 모델을 가역 변환으로 제약하여 변수 변환 공식으로 우도를 정확히 계산합니다. 셋째, Score-based/Diffusion 모델은 우도 대신 그 그래디언트인 Score를 학습하여 정규화 상수를 아예 회피합니다. 이와 별개로 GAN과 같은 암시적(implicit) 모델은 우도를 포기하는 대신 적대적 학습으로 샘플링 능력만을 추구합니다. 그림 11.1은 이 지형을 한눈에 보여 줍니다.
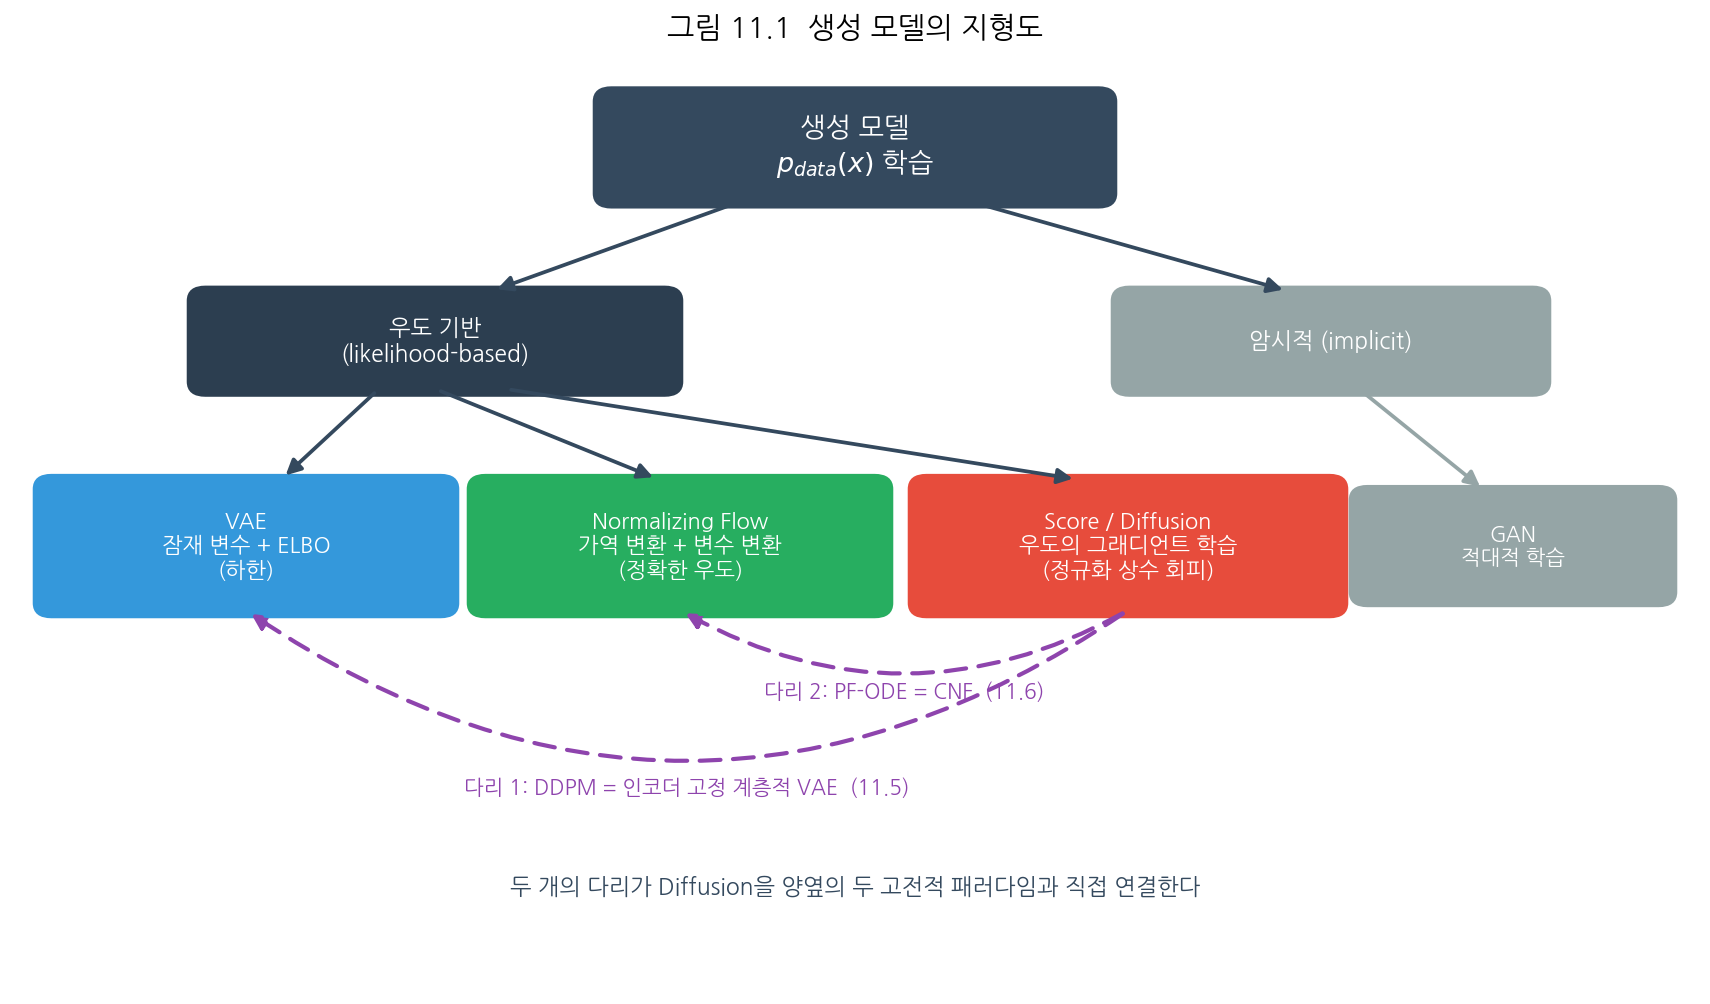
이 장의 전략은 이렇습니다. 먼저 VAE(11.2)와 Normalizing Flow(11.3)의 핵심을 간결하지만 정확하게 복습하고, Score-based/Diffusion의 본질(11.4)을 이전 장들의 언어로 다시 요약합니다. 그런 다음 두 개의 다리를 놓습니다. 11.5에서 DDPM이 계층적 VAE임을, 11.6에서 Probability Flow ODE가 Continuous Normalizing Flow임을 증명에 가까운 수준으로 보입니다. 이 두 다리가 놓이고 나면, 그림 11.1의 세 갈래는 더 이상 별개의 대륙이 아니라 하나의 지형의 서로 다른 능선임이 분명해질 것입니다.
11.2 VAE: 잠재 변수와 변분 하한
Variational Autoencoder(Kingma & Welling, 2014)는 데이터 $x$가 저차원 잠재 변수 $z$로부터 생성된다고 가정합니다. 생성 과정은 단순합니다. 먼저 사전 분포에서 잠재 변수를 뽑고($z \sim p(z)$, 보통 $\mathcal{N}(0, I)$), 디코더라 불리는 조건부 분포로 데이터를 생성합니다($x \sim p_\theta(x \mid z)$). 이때 데이터의 우도는 잠재 변수에 대한 주변화로 주어집니다.
$$ p_\theta(x) = \int p_\theta(x \mid z)\, p(z)\, dz $$
문제는 이 적분이 계산 불가능하다는 것입니다. 그리고 그 결과로 사후 분포 $p_\theta(z \mid x) = p_\theta(x \mid z)p(z) / p_\theta(x)$ 역시 계산할 수 없습니다. VAE의 해법은 이 사후 분포를 인코더라 불리는 다루기 쉬운 분포 $q_\phi(z \mid x)$(보통 대각 공분산 가우시안)로 근사하고, 로그 우도 대신 그 증거 하한(Evidence Lower Bound, ELBO)을 최대화하는 것입니다.
$$ \log p_\theta(x) \;\geq\; \mathbb{E}_{q_\phi(z \mid x)}\!\big[\log p_\theta(x \mid z)\big] \;-\; D_{\mathrm{KL}}\!\big(q_\phi(z \mid x)\,\|\,p(z)\big) \;=:\; \mathcal{L}_{\text{ELBO}}(x) $$
이 부등식은 3장과 5장에서 이미 만난 적이 있습니다. 우변의 첫 항은 인코딩한 잠재 변수로 데이터를 얼마나 잘 복원하는지를 재는 재구성 항이고, 둘째 항은 근사 사후 분포가 사전 분포에서 너무 멀어지지 않도록 잡아 두는 정칙화 항입니다. 로그 우도와 ELBO의 간극은 정확히 $D_{\mathrm{KL}}(q_\phi(z \mid x) \,\|\, p_\theta(z \mid x))$, 즉 근사 사후가 참 사후에서 벗어난 정도입니다. 따라서 ELBO를 최대화하는 것은 동시에 두 가지를 한다는 의미가 됩니다. 모델 우도를 키우고, 근사 사후를 참 사후에 가깝게 만드는 것입니다.
ELBO를 경사하강법으로 최적화하려면 $q_\phi$에 대한 기댓값을 $\phi$로 미분해야 하는데, 표본 추출 연산은 그 자체로 미분 가능하지 않습니다. VAE의 두 번째 핵심 장치인 재매개변수화 트릭(reparameterization trick)이 이 문제를 풉니다. 가우시안 인코더 $q_\phi(z \mid x) = \mathcal{N}\!\big(z; \mu_\phi(x), \sigma_\phi^2(x)\big)$에 대해 잠재 변수를 다음과 같이 다시 씁니다.
$$ z = \mu_\phi(x) + \sigma_\phi(x) \odot \epsilon, \qquad \epsilon \sim \mathcal{N}(0, I) $$
이렇게 하면 무작위성이 매개변수와 무관한 $\epsilon$으로 분리되어, 기댓값 안의 그래디언트가 신경망 $\mu_\phi, \sigma_\phi$를 통해 그대로 역전파됩니다. 4장에서 본 Forward Process의 재매개변수화 $x_t = \sqrt{\bar{\alpha}_t}\,x_0 + \sqrt{1-\bar{\alpha}_t}\,\epsilon$이 정확히 같은 트릭이었음을 떠올려 두면, 다음 절들이 한결 자연스러워집니다.
11.3 Normalizing Flow: 가역 변환과 변수 변환
Normalizing Flow(Rezende & Mohamed, 2015)는 정반대의 선택을 합니다. 하한으로 타협하는 대신, 모델을 가역 변환으로 제약하여 우도를 정확히 계산합니다. 핵심은 미적분학의 변수 변환(change of variables) 공식입니다. 가역이고 미분 가능한 사상 $f_\theta : \mathbb{R}^d \to \mathbb{R}^d$가 단순한 기저 분포 $p_Z$(예: 표준 가우시안)를 따르는 $z = f_\theta(x)$로 데이터를 보낸다고 하면, 데이터의 밀도는 다음과 같이 정확히 주어집니다.
$$ p_X(x) = p_Z\!\big(f_\theta(x)\big)\,\left|\det \frac{\partial f_\theta(x)}{\partial x}\right| $$
로그를 취하면 학습에 쓰기 좋은 형태가 됩니다.
$$ \log p_X(x) = \log p_Z\!\big(f_\theta(x)\big) + \log\left|\det J_{f_\theta}(x)\right| $$
여기서 $J_{f_\theta}$는 야코비 행렬입니다. 이 식의 의의는 명확합니다. 정규화 상수가 필요 없습니다. 우변은 기저 분포의 밀도(닫힌 형태로 알려져 있음)와 야코비 행렬식의 로그만으로 이루어져 있어, 데이터의 정확한 로그 우도를 직접 최대화할 수 있습니다. 또한 $f_\theta$가 가역이므로 생성은 단순히 역사상을 적용하는 것입니다. $z \sim p_Z$를 뽑아 $x = f_\theta^{-1}(z)$를 계산하면 됩니다.
물론 공짜는 없습니다. 일반적인 신경망의 야코비 행렬식은 $\mathcal{O}(d^3)$의 비용이 들고, 가역성과 미분 가능성을 동시에 보장하기도 어렵습니다. 실용적인 Flow들은 이 두 제약을 영리하게 푸는 변환을 설계해 왔습니다. 대표적으로 Real NVP(Dinh, Sohl-Dickstein & Bengio, 2017)의 커플링 레이어(coupling layer)는 입력을 두 부분 $x = (x_a, x_b)$로 나누고
$$ y_a = x_a, \qquad y_b = x_b \odot \exp\!\big(s_\theta(x_a)\big) + t_\theta(x_a) $$
의 형태로 변환합니다. 이렇게 하면 야코비 행렬이 삼각 행렬이 되어 그 행렬식이 대각 성분의 곱, 즉 $\sum_i s_\theta(x_a)_i$의 지수로 단번에 계산됩니다. 또한 역변환도 닫힌 형태로 주어집니다. 이런 변환을 여러 개 합성하면($f_\theta = f_K \circ \cdots \circ f_1$), 합성 사상의 로그 야코비 행렬식은 각 층의 합으로 분해되어 표현력과 계산 효율을 함께 얻습니다.
11.4 Score-based / Diffusion: 반복적 정제로서의 생성
이제 이 시리즈의 주인공을 같은 틀 안에서 다시 봅니다. Diffusion 모델은 VAE의 유연성도, Flow의 정확성도 직접 추구하지 않는 제3의 길을 택합니다. 그 길은 생성을 한 번의 도약이 아니라 수많은 작은 정제(refinement)의 연쇄로 나누는 것입니다.
6장에서 우리는 우도 대신 그 그래디언트인 Score Function $\nabla_x \log p(x)$를 학습하면 정규화 상수가 미분 과정에서 사라진다는 것을 보았습니다. $\nabla_x \log p_\theta(x) = \nabla_x \log \tilde{p}_\theta(x) - \nabla_x \log Z_\theta = \nabla_x \log \tilde{p}_\theta(x)$이기 때문입니다($Z_\theta$는 $x$와 무관하므로 그래디언트가 0). 그러나 단일 분포의 Score만으로는 저밀도 영역에서 추정이 부정확하다는 문제가 있었고, 이를 해결한 것이 여러 노이즈 수준에 걸쳐 Score를 학습하는 발상이었습니다. 데이터에 점점 더 강한 노이즈를 주입해 만든 분포들의 계열 $\{p_t\}_{t \in [0, T]}$를 정의하고, 각 수준의 Score $\nabla_x \log p_t(x)$를 하나의 신경망 $s_\theta(x, t)$로 학습합니다.
7장은 이 발상을 연속 시간으로 밀어붙여, Forward 과정을 SDE
$$ dx = f(x, t)\, dt + g(t)\, dw $$
로 적고, 생성이 그 역시간 SDE
$$ dx = \big[f(x, t) - g(t)^2\, \nabla_x \log p_t(x)\big]\, dt + g(t)\, d\bar{w} $$
를 적분하는 것임을 보였습니다. 학습된 Score $s_\theta(x, t)$가 이 방정식의 유일한 미지항을 채웁니다. 핵심은 생성이 노이즈 $x_T \sim \mathcal{N}(0, I)$에서 출발해 데이터 $x_0$에 이르는 긴 궤적이라는 점입니다. VAE가 단일 잠재 변수에서 한 번에 디코딩하고, Flow가 가역 사상으로 한 번에 변환했다면, Diffusion은 같은 노이즈→데이터 변환을 수백·수천 개의 미세한 단계로 쪼개어 수행합니다. 그림 11.2는 세 패러다임의 이 구조적 차이를 잠재 변수의 관점에서 대비합니다.
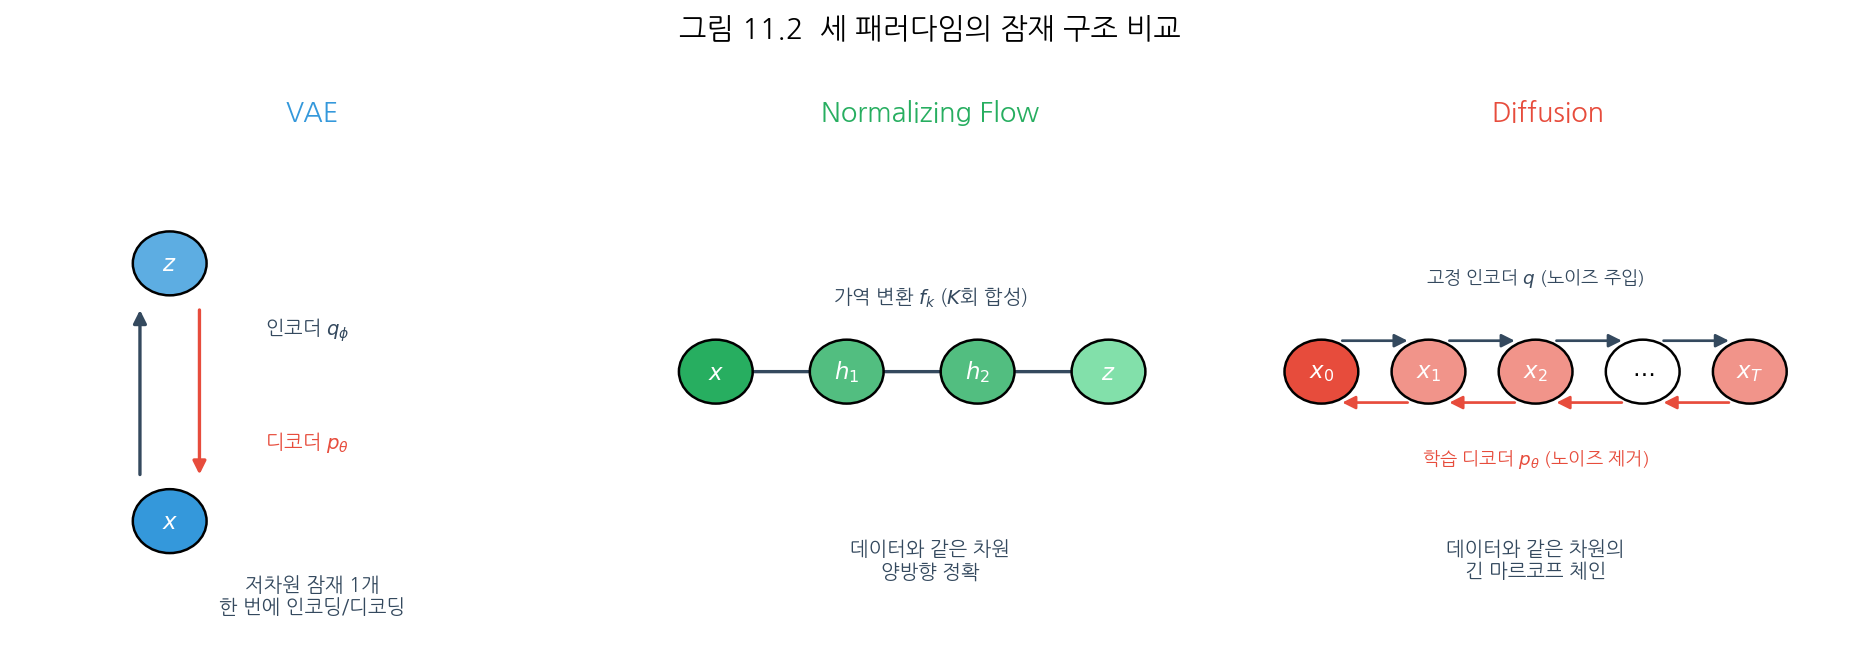
이렇게 나란히 두고 보면 한 가지 질문이 자연스럽게 떠오릅니다. Diffusion의 긴 마르코프 체인은, 잠재 변수가 데이터와 같은 차원을 가지고 인코더가 고정된 특수한 VAE로 볼 수 있지 않을까? 그리고 그 결정론적 버전인 Probability Flow ODE는, 무한히 많은 무한소 변환을 합성한 연속적인 Normalizing Flow로 볼 수 있지 않을까? 다음 두 절이 이 두 직관을 정확한 수학으로 확정합니다.
11.5 다리 ①: DDPM은 인코더가 고정된 계층적 VAE다
첫 번째 다리는 Diffusion과 VAE를 잇습니다. 결론부터 말하면, DDPM은 마르코프 계층적 변분 오토인코더(Markovian Hierarchical VAE)의 특수한 경우입니다(Luo, 2022). 이를 정확히 보이기 위해 먼저 계층적 VAE가 무엇인지 짚고, DDPM이 그것의 어떤 제약 사례인지 확인한 뒤, 5장에서 유도했던 변분 하한이 이 관점에서 어떻게 다시 나타나는지 봅니다.
11.5.1 계층적 VAE와 DDPM의 대응
계층적 VAE는 11.2의 단일 잠재 변수 $z$를 잠재 변수의 사슬 $z_1, \dots, z_T$로 확장한 모델입니다. 마르코프 구조를 가정하면 생성(디코더)과 추론(인코더)은 각각 다음과 같이 인수분해됩니다.
$$ p_\theta(x, z_{1:T}) = p(z_T)\, p_\theta(x \mid z_1) \prod_{t=2}^{T} p_\theta(z_{t-1} \mid z_t), \qquad q_\phi(z_{1:T} \mid x) = q_\phi(z_1 \mid x) \prod_{t=2}^{T} q_\phi(z_t \mid z_{t-1}) $$
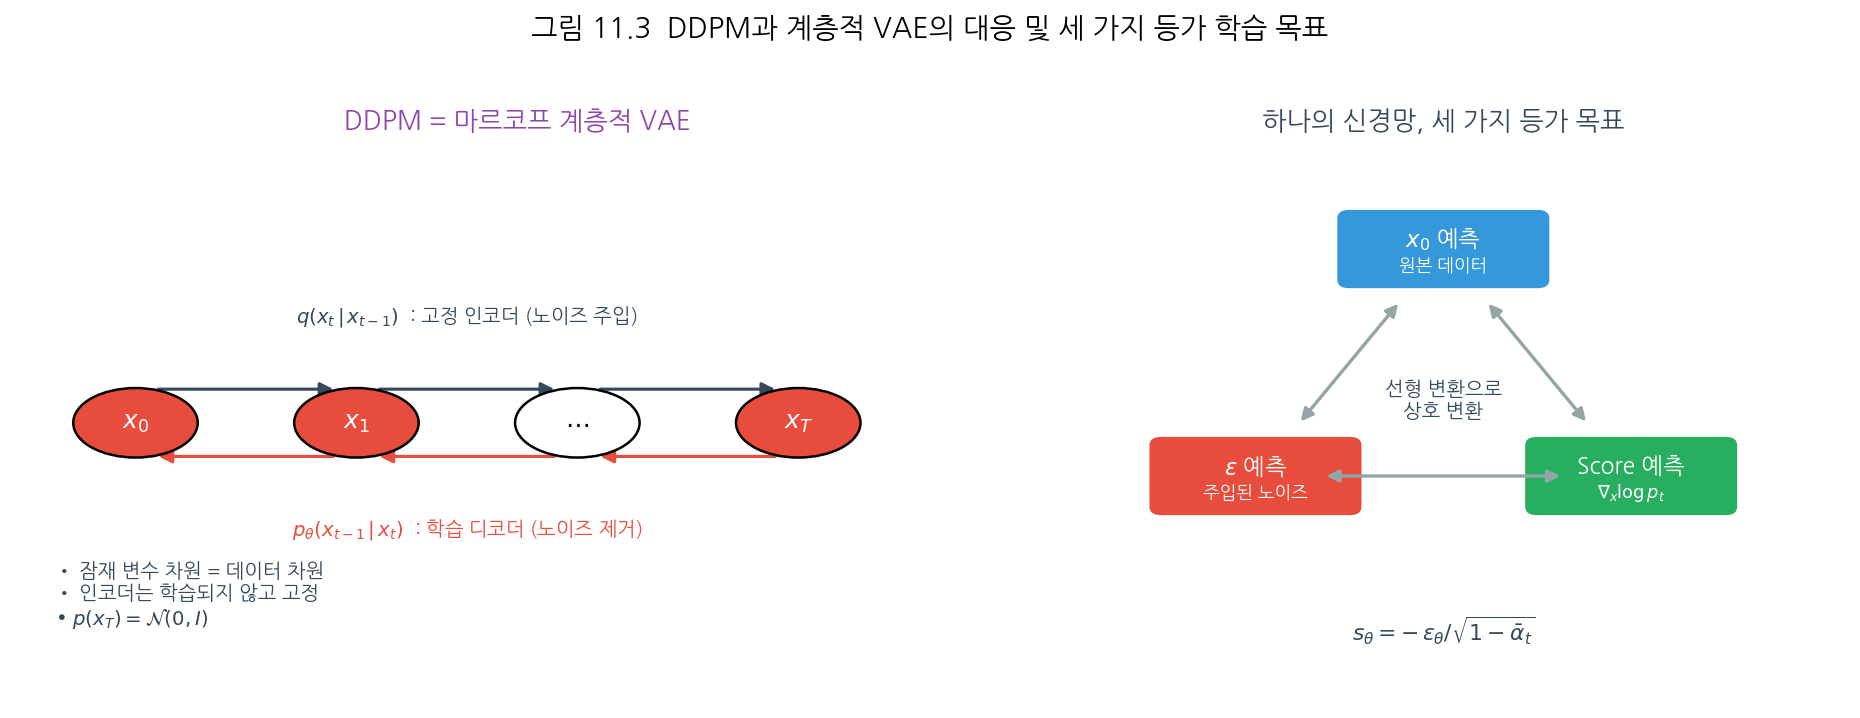
이제 변수 이름을 $z_t \to x_t$, $x \to x_0$로 바꾸고, DDPM이 부과하는 세 가지 제약을 더해 봅시다.
- 잠재 변수가 데이터와 같은 차원을 가진다. $x_1, \dots, x_T$는 모두 $x_0$와 같은 공간에 산다. 차원 축소가 없다.
- 인코더가 학습되지 않고 고정된다. $q(x_t \mid x_{t-1}) = \mathcal{N}\!\big(x_t; \sqrt{1-\beta_t}\,x_{t-1}, \beta_t I\big)$는 노이즈 스케줄 $\beta_t$만으로 정해지며 학습 매개변수 $\phi$가 없다. 4장에서 본 Forward Process가 바로 이 고정된 인코더다.
- 최종 잠재 분포가 표준 가우시안이 된다. 스케줄을 적절히 설계하면 $q(x_T \mid x_0) \approx \mathcal{N}(0, I) = p(x_T)$로, 사전 분포와 일치한다.
이 세 제약을 부과한 마르코프 계층적 VAE가 정확히 DDPM입니다. 학습 대상은 오직 디코더 $p_\theta(x_{t-1} \mid x_t)$, 즉 Reverse Process뿐입니다. 그림 11.3의 왼쪽이 이 대응을 그래프 모델로 보여 줍니다.
11.5.2 변분 하한의 재등장
이 관점의 보상은 즉각적입니다. 계층적 VAE의 ELBO를 DDPM의 인수분해에 대입하면, 우리가 5장에서 고생하며 유도했던 바로 그 변분 하한이 그대로 나옵니다.
$$ \log p_\theta(x_0) \;\geq\; \underbrace{\mathbb{E}_q\big[\log p_\theta(x_0 \mid x_1)\big]}_{\text{재구성}} \;-\; \underbrace{D_{\mathrm{KL}}\!\big(q(x_T \mid x_0) \,\|\, p(x_T)\big)}_{\text{사전 정합}} \;-\; \sum_{t=2}^{T} \underbrace{\mathbb{E}_q\big[D_{\mathrm{KL}}\!\big(q(x_{t-1} \mid x_t, x_0) \,\|\, p_\theta(x_{t-1} \mid x_t)\big)\big]}_{\text{소거 항 } L_{t-1}} $$
세 종류의 항이 보입니다. 첫째는 VAE의 재구성 항과 정확히 같은 역할을 하고, 둘째는 고정 인코더 덕분에 학습 매개변수가 없어 상수가 되며, 핵심은 셋째 합입니다. 각 $L_{t-1}$은 참 사후 $q(x_{t-1} \mid x_t, x_0)$와 모델 $p_\theta(x_{t-1} \mid x_t)$ 사이의 KL로, 3장에서 베이즈 정리로 구한 가우시안 사후 덕분에 닫힌 형태로 계산됩니다. 이것이 두 정규 분포 평균의 차이로 정리되고, 재매개변수화를 거쳐 마침내 그 유명한 노이즈 예측 손실
$$ L_{\text{simple}} = \mathbb{E}_{t, x_0, \epsilon}\left[\big\|\epsilon - \epsilon_\theta(\sqrt{\bar{\alpha}_t}\,x_0 + \sqrt{1-\bar{\alpha}_t}\,\epsilon,\; t)\big\|^2\right] $$
로 귀착되는 과정을 우리는 이미 5장에서 끝까지 따라갔습니다. 이제 그 전 과정을 한 문장으로 요약할 수 있습니다. DDPM의 학습은 인코더가 고정된 깊은 계층적 VAE의 ELBO를 최대화하는 것이며, 그 ELBO가 노이즈 예측 회귀로 단순화된 것일 뿐입니다. Kingma 등의 Variational Diffusion Models(2021)는 이 변분 하한이 확산된 데이터의 신호 대 잡음비(SNR)에 대한 놀랍도록 간결한 식으로 정리됨을 보였고, 이로써 문헌에 흩어져 있던 여러 모델이 사실상 동일함을 증명했습니다.
11.5.3 세 얼굴을 가진 하나의 목표
같은 다리에서 한 가지 통찰이 더 따라 나옵니다. DDPM의 단계별 목표는 서로 동치인 세 가지 예측 문제로 표현될 수 있습니다(Luo, 2022). 노이즈가 섞인 $x_t = \sqrt{\bar{\alpha}_t}\,x_0 + \sqrt{1-\bar{\alpha}_t}\,\epsilon$이라는 한 관계식이 세 양을 묶기 때문입니다.
- 원본 예측: 신경망이 깨끗한 데이터 $x_0$를 직접 예측한다($x_\theta(x_t, t) \approx x_0$).
- 노이즈 예측: 신경망이 주입된 노이즈 $\epsilon$을 예측한다($\epsilon_\theta(x_t, t) \approx \epsilon$). DDPM이 채택한 형태다.
- Score 예측: 신경망이 Score $\nabla_{x_t} \log p_t(x_t)$를 예측한다($s_\theta(x_t, t) \approx -\epsilon / \sqrt{1-\bar{\alpha}_t}$).
이 셋은 6장에서 본 관계 $s_\theta(x_t, t) = -\epsilon_\theta(x_t, t) / \sqrt{1-\bar{\alpha}_t}$와 $x_\theta = (x_t - \sqrt{1-\bar{\alpha}_t}\,\epsilon_\theta)/\sqrt{\bar{\alpha}_t}$를 통해 서로 선형으로 변환되며, 따라서 어느 것을 학습해도 (가중치를 무시하면) 같은 그래디언트 방향을 줍니다. 그림 11.3의 오른쪽이 이 삼각관계입니다. "변분 추론"(노이즈/원본 예측)과 "Score Matching"(Score 예측)이라는, 출발점이 전혀 다른 두 전통이 사실은 같은 신경망의 세 좌표였던 것입니다.
11.6 다리 ②: Probability Flow ODE는 Continuous Normalizing Flow다
두 번째 다리는 Diffusion과 Normalizing Flow를 잇습니다. 7장에서 우리는 모든 Diffusion SDE가 동일한 시각별 주변 분포 $p_t$를 공유하는 결정론적 짝, Probability Flow ODE를 가짐을 보았습니다.
$$ \frac{dx}{dt} = f(x, t) - \tfrac{1}{2} g(t)^2\, \nabla_x \log p_t(x) \;=:\; F_\theta(x, t) $$
우변은 학습된 Score를 대입하면 $x$와 $t$에 대한 결정론적 속도장 $F_\theta(x, t)$가 됩니다. 그런데 "노이즈에서 데이터로 가는 결정론적 가역 변환"은 정확히 11.3에서 본 Normalizing Flow의 정의입니다. 다만 여기서는 변환이 이산적인 층들의 합성이 아니라, 연속 시간에 걸친 ODE의 흐름(flow)이라는 점이 다릅니다. 이것이 바로 Continuous Normalizing Flow(CNF)입니다(Chen et al., 2018, Neural ODE).
11.6.1 순간 변수 변환과 정확한 우도
이 다리가 놓이는 결정적 순간은 변수 변환 공식의 연속 시간 버전입니다. 11.3의 이산 공식 $\log p_X(x) = \log p_Z(f(x)) + \log|\det J_f(x)|$를 무한소 시간 간격에 적용하면, 야코비 행렬식의 로그가 미분 형태로 바뀌어 다음의 순간 변수 변환(instantaneous change of variables) 공식을 얻습니다(Chen et al., 2018).
$$ \frac{d \log p_t(x(t))}{dt} = -\,\nabla \cdot F_\theta(x(t), t) = -\,\operatorname{tr}\!\left(\frac{\partial F_\theta}{\partial x}\right) $$
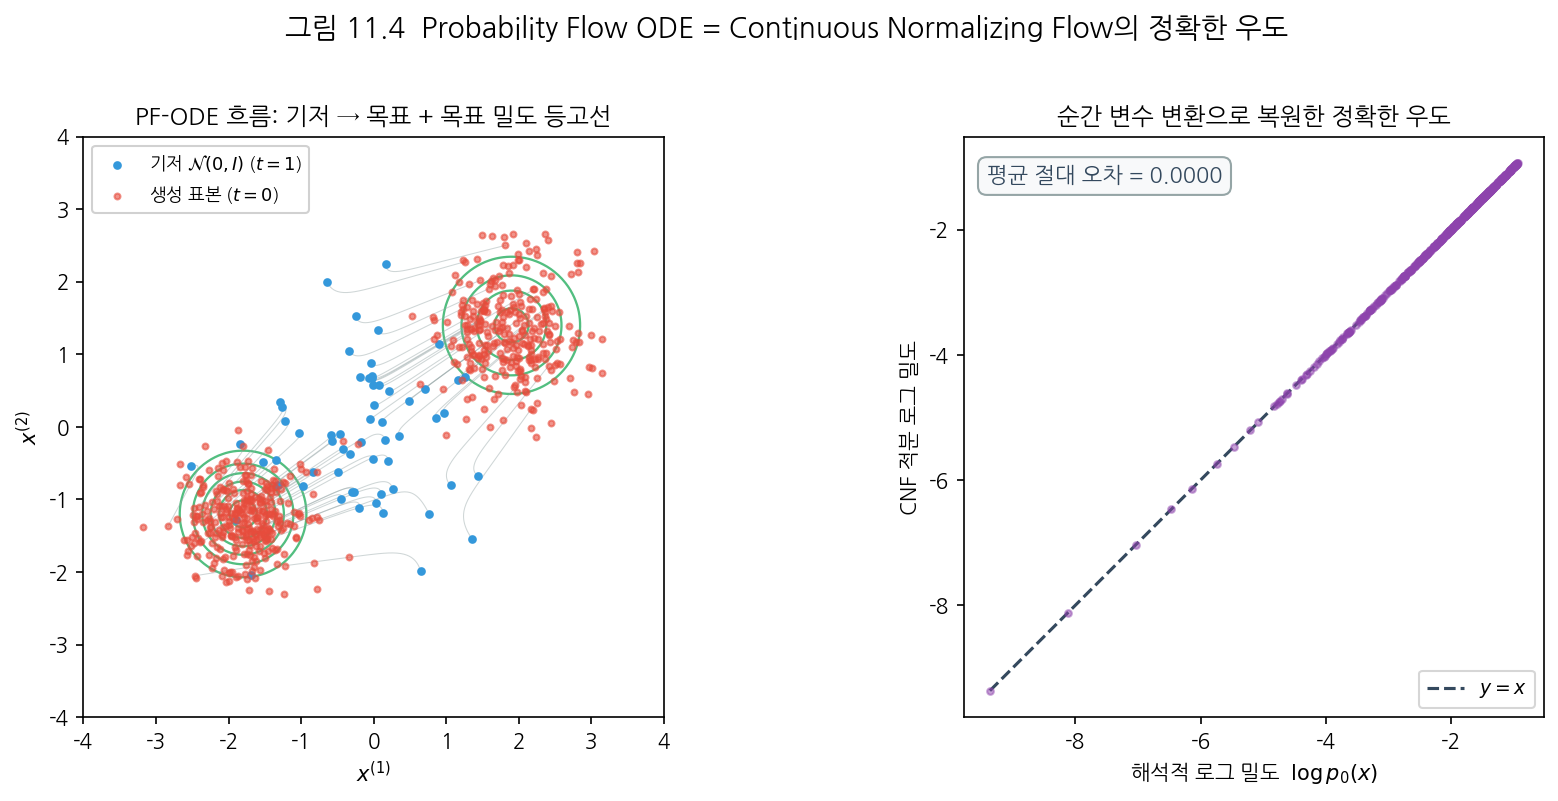
이 식의 의미는 강력합니다. ODE를 시간에 대해 적분하여 노이즈 $x(T)$에서 데이터 $x(0)$로 가는 동안, 속도장의 발산(divergence)을 함께 적분하기만 하면 데이터의 정확한 로그 우도를 얻습니다.
$$ \log p_0(x(0)) = \log p_T(x(T)) + \int_0^T \nabla \cdot F_\theta(x(t), t)\, dt $$
이산 Flow에서 야코비 행렬식이 $\mathcal{O}(d^3)$로 비쌌던 것과 달리, 여기서는 그 자리를 트레이스(발산)가 대신하며, Hutchinson 추정량으로 효율적으로 근사할 수 있습니다(FFJORD 류의 접근). 요점은 이것입니다. Score만 학습했을 뿐인 Diffusion 모델이, 그 Probability Flow ODE를 통해 Normalizing Flow와 똑같이 정확한 우도를 계산해 낼 수 있습니다. VAE처럼 하한에 머무를 필요가 없는 것입니다. 그림 11.4는 해석적으로 알려진 속도장을 가진 간단한 2차원 예에서 이 사실을 직접 확인합니다. ODE 궤적을 따라 적분한 우도가 참 밀도와 일치합니다.
11.6.2 Flow Matching이라는 지름길
이 다리는 10장의 내용과 곧장 이어집니다. Probability Flow ODE가 하나의 CNF라면, 그 속도장을 굳이 Score를 거쳐 간접적으로 얻을 이유가 없습니다. Flow Matching(Lipman et al., 2023)은 우리가 원하는 확률 경로를 먼저 설계하고 그것을 생성하는 속도장을 직접 회귀합니다. Diffusion의 노이즈 주입이 만든 굽은 경로 대신 Optimal Transport의 직선 경로를 택하면, 같은 CNF의 틀 안에서 훨씬 적은 적분 단계로 생성이 가능해집니다. 즉 Flow Matching은 "Diffusion = CNF"라는 이 다리를 가장 적극적으로 활용하는 방법론이며, 10장에서 본 Rectified Flow와 Stable Diffusion 3가 그 산업적 결실이었습니다.
11.7 네 패러다임의 비교
두 다리를 놓았으니, 이제 네 계열을 같은 표 위에서 공정하게 비교할 수 있습니다. 각 모델이 "무엇을 정확히 얻고 무엇을 포기하는가"라는 질문으로 정리하면 다음과 같습니다.
| 기준 | VAE | Normalizing Flow | Diffusion / Score | GAN (참고) |
|---|---|---|---|---|
| 우도 | 하한(ELBO)만 | 정확 | ELBO 또는 ODE로 정확 | 없음(암시적) |
| 샘플링 비용 | 1회 (빠름) | 1회 (빠름) | 다수 단계 (느림) | 1회 (빠름) |
| 샘플 품질 | 중간(흐릿함 경향) | 중간 | 최고 수준 | 높음 |
| 잠재 차원 | 저차원(압축) | 데이터와 동일 | 데이터와 동일 | 저차원 |
| 학습 안정성 | 안정 | 안정 | 매우 안정 | 불안정(적대적) |
| 구조적 제약 | 약함 | 강함(가역·차원 보존) | 약함 | 약함 |
이 표는 Diffusion이 왜 현재 지배적인지를 설명합니다. Diffusion은 VAE 수준의 약한 구조적 제약(임의의 신경망을 쓸 수 있음)과 GAN을 능가하는 학습 안정성, 그리고 Flow 수준의 정확한 우도를 한 모델에 모읍니다. 유일한 약점은 샘플링 비용인 긴 궤적을 적분해야 한다는 점이었고, 이것이 바로 9장과 10장의 Optimal Transport·Flow Matching·Rectified Flow가, 그리고 다음 절의 증류 기법이 공략한 표적이었습니다.
11.8 결합과 증류: 경계를 넘나드는 모델들
패러다임들이 하나의 지형 위에 있다는 사실의 가장 실용적인 귀결은, 그것들을 자유롭게 결합할 수 있다는 점입니다. 두 가지 대표 사례가 이 점을 분명히 보여 줍니다.
11.8.1 Latent Diffusion: VAE의 잠재 공간 위에서 확산하기
Latent Diffusion Model(Rombach et al., 2022)은 VAE와 Diffusion을 문자 그대로 한 파이프라인에 직렬로 연결합니다. 먼저 VAE의 인코더로 고해상도 이미지를 저차원 잠재 표현으로 압축하고, 픽셀 공간이 아니라 이 압축된 잠재 공간 위에서 Diffusion을 수행한 뒤, VAE의 디코더로 다시 이미지로 복원합니다. 이 설계의 동기는 명확합니다. Diffusion의 약점인 높은 계산 비용은 데이터 차원에 직결되는데, VAE로 지각적으로 중요하지 않은 세부를 먼저 걷어 내고 나면 Diffusion이 훨씬 작은 공간에서 의미 있는 구조에만 집중할 수 있습니다. 11.7 표의 용어로 말하면, VAE의 "저차원 압축"과 Diffusion의 "고품질 생성"을 결합한 것입니다. Stable Diffusion을 비롯한 오늘날 대부분의 대규모 이미지 생성 모델이 이 구조를 따릅니다.
11.8.2 Consistency Model: ODE 궤적을 한 번에 건너뛰기
Consistency Model(Song et al., 2023)은 다른 방향에서 결합을 시도합니다. 11.6에서 본 Probability Flow ODE의 궤적은 노이즈 $x_T$에서 데이터 $x_0$로 가는 잘 정의된 결정론적 경로입니다. Consistency Model은 이 궤적 위의 어느 점에서 출발하든 곧장 그 시작점(데이터 $x_0$)으로 보내는 사상 $f_\theta(x_t, t) \approx x_0$를 학습합니다. 핵심 조건은 이름 그대로 일관성(consistency)입니다. 같은 궤적 위의 모든 점은 같은 $x_0$로 사상되어야 한다는 것입니다. 이 사상을 한 번 학습하고 나면, 긴 ODE를 적분할 필요 없이 노이즈에서 단 한 번의 신경망 평가로 데이터를 생성할 수 있습니다. Consistency Model은 미리 학습된 Diffusion 모델을 증류(distillation)하여 얻을 수도 있고, 독립적인 생성 모델로 처음부터 학습할 수도 있습니다. 이는 Diffusion의 유일한 약점이었던 샘플링 비용을, 모델 계열을 넘나드는 발상으로 정면 돌파한 사례입니다.
11.9 큰 그림: 하나의 지형도
이제 그림 11.1의 지형도를 다시 봅시다. 처음에는 세 갈래로 갈라진 별개의 대륙처럼 보였던 것이, 두 개의 다리(11.5, 11.6)와 여러 결합 사례(11.8)를 거치고 나면 하나의 연속된 지형의 능선들로 다시 읽힙니다. 이 지형 전체를 관통하는 단 하나의 관점이 있다면, 그것은 10장에서 만난 흐름(flow)으로서의 생성이라는 관점입니다.
모든 생성 모델은 결국 다루기 쉬운 단순한 분포를 복잡한 데이터 분포로 옮기는 수송의 문제로 환원됩니다. VAE는 이 수송을 단일 잠재 변수를 거치는 한 번의 확률적 도약으로, Normalizing Flow는 가역 사상의 합성으로, Diffusion은 긴 확률 미분방정식의 적분으로, 그리고 Flow Matching은 우리가 직접 설계한 속도장을 따르는 ODE의 흐름으로 수행합니다. 서로 다른 것은 경로의 모양과 그것을 학습하는 방식일 뿐, 출발점(단순한 분포)과 도착점(데이터)은 언제나 같습니다. Diffusion이 이 지형의 중심에 서게 된 이유는, 두 개의 다리를 통해 양옆의 두 전통이 가진 미덕인 VAE의 유연성과 Flow의 정확성을 동시에 물려받으면서도, 변분 추론·Score Matching·SDE/ODE·Optimal Transport라는 네 개의 서로 다른 수학적 언어 모두로 자신을 설명할 수 있기 때문입니다.
11.10 시리즈를 마치며
열한 개의 장을 통해 우리는 하나의 긴 궤적을 함께 그렸습니다. 노이즈에서 이미지로 가는 직관(1–2장)에서 출발해, DDPM의 변분 하한을 한 줄도 건너뛰지 않고 유도했고(3–5장), 그 노이즈 예측이 Score Matching과 같은 것임을 확인한 뒤 연속 시간 SDE/ODE로 시야를 넓혔으며(6–7장), 조건부 생성의 수학(8장)을 거쳐 Optimal Transport의 기하학과 Flow Matching이라는 현대적 지평(9–10장)에 이르렀습니다. 그리고 이 마지막 장에서 우리는 출발점으로 돌아와, 그동안 다룬 모든 조각이 사실은 하나의 그림이었음을 확인했습니다.
이 시리즈가 한 가지를 남긴다면, 그것은 특정 모델의 공식이 아니라 관점을 자유롭게 옮겨 다니는 훈련이기를 바랍니다. 같은 Diffusion 모델을 어느 날은 계층적 VAE로, 다른 날은 Score 추정기로, 또 다른 날은 미분방정식의 흐름이나 최적 수송의 근사로 바라볼 수 있을 때, 우리는 비로소 각 관점이 가린 것과 드러낸 것을 분별하고 다음 한 걸음이 어디일지 가늠할 수 있습니다. 생성 모델의 지형은 지금 이 순간에도 더 빠르고, 더 정확하고, 더 제어 가능한 방향으로 재편되고 있습니다. 그 변화의 한복판에서 길을 잃지 않는 가장 든든한 나침반은, 결국 이 시리즈가 거듭 확인해 온 사실 하나입니다. 모든 생성 모델은 서로 연결되어 있습니다.
개인적으로도 Diffusion 시리즈를 완성하게 되어서 기쁩니다. 이와 같은 긴 내용을 작성해보는 과정이 저에게 좋은 경험이 된 것 같습니다. 차후에도 특정 다른 주제에 대해서 유사한 방식으로 긴 글을 작성해볼 것 같습니다.
참고문헌
- Kingma, D. P., & Welling, M. (2014). Auto-Encoding Variational Bayes. International Conference on Learning Representations. arXiv:1312.6114
- Rezende, D. J., & Mohamed, S. (2015). Variational Inference with Normalizing Flows. Proceedings of the 32nd International Conference on Machine Learning, PMLR 37, 1530-1538. arXiv:1505.05770
- Dinh, L., Sohl-Dickstein, J., & Bengio, S. (2017). Density Estimation using Real NVP. International Conference on Learning Representations. arXiv:1605.08803
- Sohl-Dickstein, J., Weiss, E. A., Maheswaranathan, N., & Ganguli, S. (2015). Deep Unsupervised Learning using Nonequilibrium Thermodynamics. Proceedings of the 32nd International Conference on Machine Learning, PMLR 37, 2256-2265. arXiv:1503.03585
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. Advances in Neural Information Processing Systems, 33, 6840-6851. arXiv:2006.11239
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., & Poole, B. (2021). Score-Based Generative Modeling through Stochastic Differential Equations. International Conference on Learning Representations. arXiv:2011.13456
- Chen, R. T. Q., Rubanova, Y., Bettencourt, J., & Duvenaud, D. (2018). Neural Ordinary Differential Equations. Advances in Neural Information Processing Systems, 31, 6572-6583. arXiv:1806.07366
- Kingma, D. P., Salimans, T., Poole, B., & Ho, J. (2021). Variational Diffusion Models. Advances in Neural Information Processing Systems, 34. arXiv:2107.00630
- Luo, C. (2022). Understanding Diffusion Models: A Unified Perspective. arXiv:2208.11970
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., & Le, M. (2023). Flow Matching for Generative Modeling. International Conference on Learning Representations. arXiv:2210.02747
- Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-Resolution Image Synthesis with Latent Diffusion Models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 10684-10695. arXiv:2112.10752
- Song, Y., Dhariwal, P., Chen, M., & Sutskever, I. (2023). Consistency Models. Proceedings of the 40th International Conference on Machine Learning, PMLR 202. arXiv:2303.01469
'인공지능 논문 정리 > Diffusiion' 카테고리의 다른 글
| [Diffusion 10] OT에서 Flow Matching으로: Rectified Flow와 Schrödinger Bridge (0) | 2026.06.13 |
|---|---|
| [Diffusion 9] Optimal Transport 입문: Wasserstein 거리와 최적 경로 (0) | 2026.06.12 |
| [Diffusion 8] Guidance의 수학: 조건부 생성을 가능케 하는 원리 (0) | 2026.06.11 |
| [Diffusion 7] 연속 시간으로의 확장: SDE와 ODE 관점에서 본 Diffusion (0) | 2026.06.07 |
| [Diffusion 6] Score Function이란 무엇인가: Score Matching에 대한 이해 (2) | 2026.01.20 |


