The straight paths are special and preferred because they are the shortest paths between two points, and can be simulated exactly without time discretization and hence yield computationally efficient models.
Liu, Gong & Liu, Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow (2022)
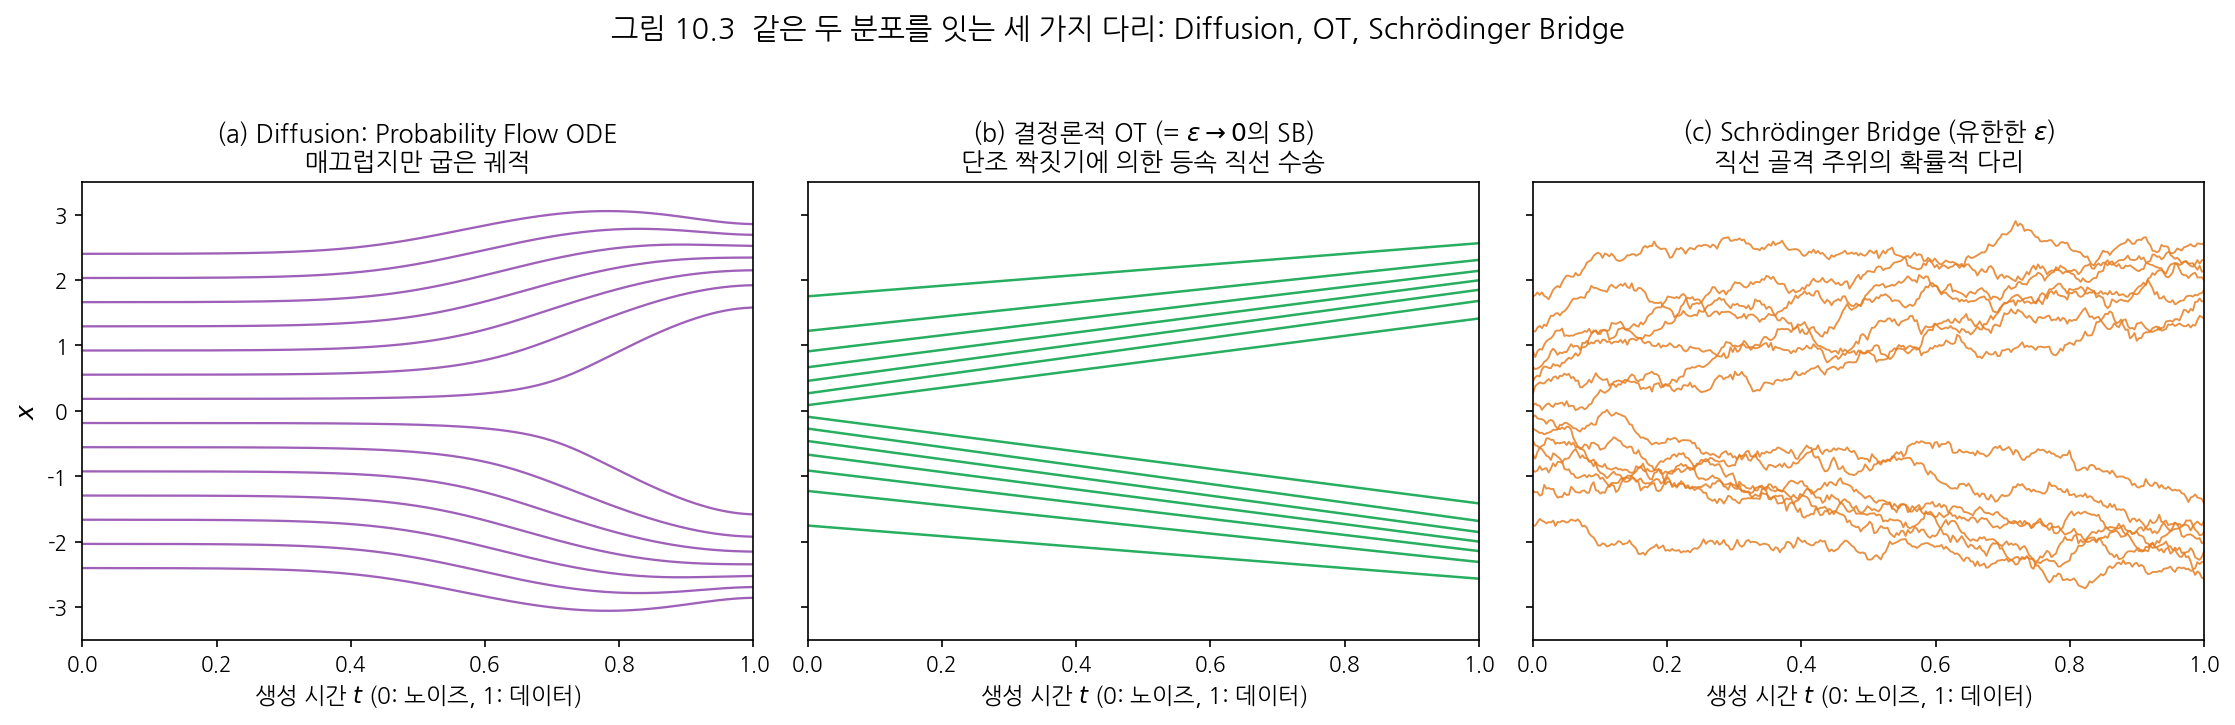
9장에서 우리는 한 분포를 다른 분포로 옮기는 가장 효율적인 방법을 묻는 수학, Optimal Transport를 구축했습니다. Kantorovich의 커플링, Wasserstein 거리, Brenier의 최적 사상, 그리고 두 분포 사이의 측지선인 displacement interpolation까지, 이 기하학의 결론은 명료했습니다. $W_2$ 기하학에서 최적의 경로는 모든 입자가 등속 직선 운동을 하는 경로라는 것입니다. 그리고 9.6절의 그림 9.4에서 우리는 불편한 사실을 목격했습니다. Diffusion의 Probability Flow ODE가 그리는 궤적은 직선이 아니라 심하게 굽어 있으며, 따라서 같은 두 분포를 잇는 데 필요 이상으로 "먼 길"을 돌아간다는 것입니다.
이번 장은 이 관찰을 출발점으로 삼아, 지난 몇 년 사이 생성 모델의 지형을 바꾼 새로운 패러다임을 다룹니다. 핵심 아이디어는 단순합니다. 경로를 노이즈 주입 과정의 부산물로 받아들이지 말고, 우리가 원하는 경로를 직접 설계한 뒤 그 경로를 따라가는 속도장(velocity field)을 학습하자는 것입니다. 이것이 Flow Matching(Lipman et al., 2023)의 관점이며, 그 특수한 구현인 Rectified Flow(Liu et al., 2023)는 경로를 반복적으로 직선화하여 단 몇 step, 극단적으로는 단 한 step의 생성을 가능하게 합니다. 이 방법은 더 이상 이론적 호기심이 아닙니다. Stable Diffusion 3(Esser et al., 2024)가 Rectified Flow를 채택하면서, "Diffusion Model"이라 불리는 최신 대규모 생성 모델의 상당수는 사실상 Flow Matching으로 학습되고 있습니다. 그리고 장의 마지막에서 우리는 이 모든 것을 확률적 관점에서 통합하는 Schrödinger Bridge를 만납니다. 1931년 슈뢰딩거가 던진 질문이 entropic OT와 Diffusion을 하나의 문제의 두 얼굴로 묶어내는 과정은, 이 시리즈가 추구해 온 "통합적 이해"의 가장 아름다운 사례 중 하나가 될 것입니다.
10.1 Diffusion의 한계 재조명: 경로는 주어지는 것이 아니라 설계하는 것
10.1.1 우리가 서 있는 곳
Part 2와 Part 3에서 구축한 Diffusion의 구조를 한 문장으로 요약하면 다음과 같습니다. Forward SDE가 데이터 분포 $p_{\mathrm{data}}$를 가우시안으로 밀어 보내는 확률 경로 $\{p_t\}_{t\in[0,T]}$를 정의하고, 신경망은 그 경로의 Score $\nabla_x \log p_t(x)$를 학습하며, 샘플링은 Reverse SDE 또는 Probability Flow ODE로 이 경로를 거꾸로 따라갑니다. 이 구조는 우아하지만, 경로 자체에 대한 선택권이 우리에게 거의 없다는 점에 주목해야 합니다. 일단 forward SDE의 형태(VP, VE 등)를 고르고 나면, 확률 경로는 그 SDE의 풀이로서 자동으로 결정됩니다. 9장의 언어로 말하면, Diffusion은 "어떤 경로로 분포를 옮길 것인가"라는 질문에 답하지 않습니다. 노이즈 주입이라는 물리적 과정이 경로를 대신 결정해 버리기 때문입니다.
이 수동성이 낳는 비용은 세 가지로 정리할 수 있습니다. 첫째, 경로가 굽어 있습니다. 7장에서 보았듯이 Probability Flow ODE의 궤적은 시간에 따라 방향이 계속 변하는 곡선이며, 9.6절에서 확인했듯이 이는 $W_2$ 측지선이 아닙니다. 굽은 경로는 수치 적분 관점에서 치명적입니다. Euler 방법의 국소 절단 오차는 궤적의 곡률(2차 도함수)에 비례하므로, 굽은 경로를 정확히 따라가려면 작은 step, 즉 많은 신경망 평가가 필요합니다. 둘째, 사전 분포에 정확히 도달하지 못합니다. VP-SDE의 주변 분포가 표준 가우시안이 되는 것은 $T \to \infty$의 극한에서일 뿐이며, 유한한 $T$에서는 언제나 근사 오차가 남습니다. De Bortoli et al.(2021)이 지적했듯이, 이는 forward SDE를 "충분히 오래" 돌려야 한다는 제약으로 이어집니다. 셋째, 출발 분포가 가우시안이어야 합니다. 노이즈 주입 과정의 종착지는 언제나 가우시안이므로, 임의의 분포 $\pi_0$에서 임의의 분포 $\pi_1$로의 변환인, 예컨대 한 이미지 도메인에서 다른 도메인으로의 번역은 Diffusion의 틀에 자연스럽게 들어오지 않습니다.
10.1.2 Continuous Normalizing Flow와 시뮬레이션의 굴레
경로를 직접 설계하는 모델의 원형은 사실 Diffusion보다 먼저 존재했습니다. Chen et al.(2018)의 Neural ODE는 신경망 $v_\theta$가 정의하는 상미분방정식
$$ \frac{dx(t)}{dt} = v_\theta(t, x(t)), \qquad x(0) \sim p_0 $$
으로 입자를 흘려보내는 모델이며, 이를 생성 모델로 쓴 것이 Continuous Normalizing Flow(CNF)입니다. 속도장 $v_\theta$가 입자들을 운반하면, 분포의 밀도는 연속 방정식(continuity equation)
$$ \frac{\partial p_t(x)}{\partial t} + \nabla \cdot \big( p_t(x)\, v_\theta(t, x) \big) = 0 $$
을 따라 변형됩니다. 이 방정식은 9.6절의 Benamou–Brenier 공식에서 제약 조건으로 등장했던 바로 그 질량 보존 법칙입니다. 즉 CNF는 처음부터 "속도장으로 분포를 옮기는 모델"이라는, OT의 동역학적 정식화와 같은 무대 위에 서 있었습니다.
문제는 학습이었습니다. CNF의 전통적 학습은 최대 가능도, 즉 $\log p_\theta(x)$를 직접 최대화하는 방식인데, 이 값을 한 번 평가하려면 ODE를 처음부터 끝까지 시뮬레이션해야 합니다(순간 변수 변환 공식에 따라 발산항 $\nabla \cdot v_\theta$의 시간 적분도 함께 계산해야 합니다). 학습 루프의 매 반복마다 수십~수백 번의 신경망 평가가 들어가는 ODE 풀이가 필요하므로, CNF는 Diffusion과 같은 규모로 확장되지 못했습니다. 정리하면 2022년 무렵의 상황은 다음과 같은 딜레마였습니다. Diffusion은 학습이 시뮬레이션 없이 가능하지만 경로를 설계할 수 없고, CNF는 경로(속도장)를 자유롭게 설계할 수 있지만 학습에 시뮬레이션이 필요하다. Flow Matching은 정확히 이 딜레마를 해소합니다. CNF의 표현력을 유지하면서, Diffusion처럼 단순한 회귀 손실 하나로 학습하는 방법을 제시하기 때문입니다.
10.2 Flow Matching: 속도장을 직접 회귀하다
10.2.1 문제 설정: 확률 경로와 속도장
Flow Matching(Lipman et al., 2023)의 설정은 다음과 같습니다. 사전 분포 $p_0$(보통 표준 가우시안)와 데이터 분포 $q = p_1$이 주어져 있고, 두 분포를 잇는 확률 경로 $\{p_t\}_{t \in [0,1]}$와 그 경로를 생성하는 목표 속도장 $u_t(x)$가 있다고 합시다. "생성한다"는 말의 의미는 연속 방정식입니다. 즉 $u_t$를 따라 입자를 흘려보냈을 때 시각 $t$의 입자 분포가 정확히 $p_t$가 된다는 뜻입니다.
$$ \frac{\partial p_t(x)}{\partial t} + \nabla \cdot \big( p_t(x)\, u_t(x) \big) = 0 $$
만약 우리가 $u_t$를 알고 있다면 생성은 끝난 이야기입니다. $x_0 \sim p_0$에서 출발해 ODE $\frac{dx}{dt} = u_t(x)$를 $t=0$부터 $t=1$까지 풀면 $x_1 \sim p_1 = q$를 얻기 때문입니다. 따라서 학습 목표는 신경망 $v_\theta$를 $u_t$에 회귀시키는 것, 즉 다음의 Flow Matching 손실을 최소화하는 것입니다.
$$ \mathcal{L}_{\mathrm{FM}}(\theta) = \mathbb{E}_{t \sim \mathcal{U}[0,1],\; x \sim p_t} \left\| v_\theta(t, x) - u_t(x) \right\|^2 $$
이 손실은 Diffusion의 노이즈 예측 손실과 같은 구조의 단순한 $L^2$ 회귀입니다. 시뮬레이션이 전혀 필요 없습니다. 그러나 여기에는 명백한 순환 논리가 숨어 있습니다. 우리는 $p_t$도 $u_t$도 모릅니다. 애초에 데이터 분포 $q$를 모르기 때문에 생성 모델을 학습하는 것인데, $q$를 끝점으로 갖는 확률 경로와 그 속도장을 어떻게 손에 넣는단 말입니까? Flow Matching 손실은 그 자체로는 계산 불가능(intractable)합니다.
10.2.2 Conditional Flow Matching: 조건부로 쪼개면 풀린다
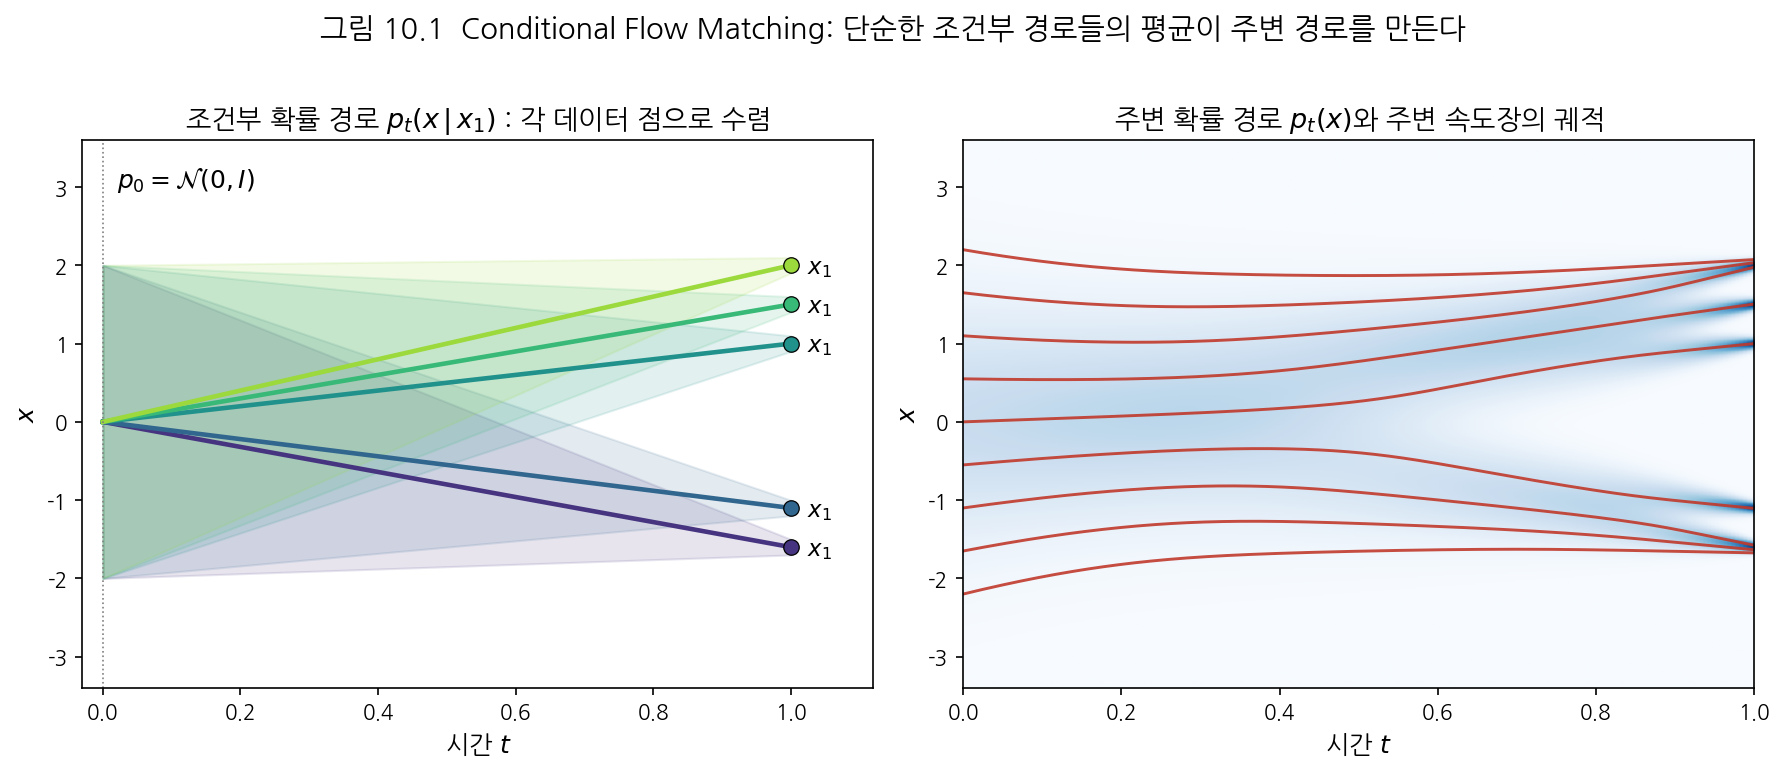
Lipman et al.(2023)의 해결책은 5장에서 DDPM의 변분 하한을 다룰 때 보았던 전략과 정신적으로 동일합니다. 전체로는 다룰 수 없는 대상을, 데이터 한 점에 조건을 건 다루기 쉬운 조각들로 분해하는 것입니다. 데이터 한 점 $x_1 \sim q$를 고정하고, 그 점으로 수렴하는 조건부 확률 경로 $p_t(x \mid x_1)$를 우리가 직접 설계합니다. 경계 조건은 $p_0(x \mid x_1) = p_0(x)$ (출발은 사전 분포), $p_1(x \mid x_1) \approx \delta_{x_1}$ (도착은 데이터 점 주변의 좁은 분포)입니다. 조건부 경로는 단순한 분포(예: 가우시안)로 잡을 수 있으므로, 그것을 생성하는 조건부 속도장 $u_t(x \mid x_1)$도 닫힌 형태로 적을 수 있습니다.
주변(marginal) 확률 경로와 주변 속도장은 조건부 조각들을 데이터 분포로 섞어서 복원됩니다.
$$ p_t(x) = \int p_t(x \mid x_1)\, q(x_1)\, dx_1, \qquad u_t(x) = \int u_t(x \mid x_1)\, \frac{p_t(x \mid x_1)\, q(x_1)}{p_t(x)}\, dx_1 $$
두 번째 식은 조건부 속도장들의 사후 가중 평균입니다. 점 $x$를 지나는 여러 조건부 경로가 있을 때, "그 점이 어느 $x_1$을 향해 가는 중일 확률"로 속도를 평균한 것이 주변 속도장이라는, 직관적으로도 자연스러운 식입니다. 그리고 이렇게 정의된 $u_t$가 실제로 주변 경로 $p_t$를 생성한다는 것(연속 방정식을 만족한다는 것)을 적분 교환으로 증명할 수 있습니다. 하지만 $u_t$ 안에는 여전히 계산 불가능한 $p_t(x)$가 들어 있습니다. 핵심 기여는 다음 정리입니다.
증명의 뼈대는 제곱을 전개하는 것뿐입니다. $\|v_\theta - u\|^2 = \|v_\theta\|^2 - 2\langle v_\theta, u\rangle + \|u\|^2$에서 마지막 항은 $\theta$와 무관하므로 그래디언트에 기여하지 않습니다. 첫째 항의 기댓값은 두 손실에서 동일합니다($x$의 주변 분포가 같으므로). 둘째 항은 주변 속도장의 정의를 대입하면
$$ \mathbb{E}_{x \sim p_t} \langle v_\theta(t,x),\, u_t(x) \rangle = \int \langle v_\theta(t,x),\, u_t(x \mid x_1) \rangle\, p_t(x \mid x_1)\, q(x_1)\, dx_1\, dx = \mathbb{E}_{x_1 \sim q,\, x \sim p_t(\cdot\mid x_1)} \langle v_\theta(t,x),\, u_t(x \mid x_1) \rangle $$
이 되어 역시 두 손실에서 같습니다. 이로써 학습 알고리즘이 완성됩니다. 데이터 $x_1$을 뽑고, 시각 $t$를 뽑고, 조건부 경로에서 $x$를 뽑은 뒤, 닫힌 형태의 조건부 속도 $u_t(x \mid x_1)$를 신경망이 맞히도록 회귀합니다. 신경망은 각 미니배치에서 개별 데이터 점을 향하는 속도를 배우지만, 손실의 기댓값 구조 덕분에 수렴점에서는 자동으로 주변 속도장, 즉 분포 전체를 옮기는 속도이 됩니다. 그림 10.1은 이 분해를 시각화한 것입니다. 개별 데이터 점으로 수렴하는 단순한 조건부 경로들(왼쪽)이 데이터 분포로 가중 평균되면, 전체 분포를 운반하는 매끄러운 주변 경로(오른쪽)가 만들어집니다.
10.2.3 가우시안 경로 족: Diffusion은 특수 사례다
조건부 경로를 가우시안 족
$$ p_t(x \mid x_1) = \mathcal{N}\big(x;\; \mu_t(x_1),\; \sigma_t(x_1)^2 I\big) $$
로 잡으면 이야기가 매우 구체적이 됩니다. 평균 $\mu_t$와 표준편차 $\sigma_t$의 스케줄만 정하면 경로가 정해지고, 이 경로를 생성하는 조건부 속도장은 다음의 닫힌 형태를 가집니다(Lipman et al., 2023).
$$ u_t(x \mid x_1) = \frac{\sigma_t'(x_1)}{\sigma_t(x_1)} \big( x - \mu_t(x_1) \big) + \mu_t'(x_1) $$
여기서 $'$은 시간 미분입니다. 이 식 하나가 거대한 설계 공간을 엽니다. 두 가지 선택을 비교해 봅시다.
선택 1 Diffusion 경로. $\mu_t, \sigma_t$를 4장에서 유도한 VP forward process의 주변 분포 $q(x_t \mid x_0) = \mathcal{N}(\sqrt{\bar\alpha_t}\, x_0,\, (1-\bar\alpha_t) I)$에 맞추면(시간 방향의 관례 차이만 조정하면), Flow Matching은 정확히 Diffusion의 확률 경로 위에서 작동합니다. Lipman et al.(2023)은 이 경우의 FM 학습이 기존 Score Matching 기반 학습보다 더 안정적인 대안이 됨을 보였습니다. 즉 Diffusion은 Flow Matching이라는 더 큰 틀의 한 점입니다.
선택 2 OT 경로. 9장의 displacement interpolation에서 영감을 받아 평균과 표준편차를 시간의 일차 함수로 잡습니다.
$$ \mu_t(x_1) = t\, x_1, \qquad \sigma_t(x_1) = 1 - (1 - \sigma_{\min})\, t $$
이때 각 조건부 경로는 표준 가우시안에서 $x_1$ 주변의 좁은 가우시안 $\mathcal{N}(x_1, \sigma_{\min}^2 I)$로 가는 가우시안 사이의 $W_2$ 측지선이 되며(9.4절에서 본 가우시안 Wasserstein 거리의 닫힌 형태가 여기서 다시 등장합니다), 조건부 속도장은
$$ u_t(x \mid x_1) = \frac{x_1 - (1 - \sigma_{\min})\, x}{1 - (1 - \sigma_{\min})\, t} $$
가 됩니다. 결정적인 차이는 입자 궤적의 모양입니다. 조건부 flow는 $\psi_t(x_0) = (1 - (1-\sigma_{\min})t)\, x_0 + t\, x_1$, 즉 등속 직선 운동입니다. Diffusion 경로에서는 입자가 처음에 거의 움직이지 않다가 마지막에 급격히 이동하는(혹은 그 반대의) 불균등한 시간 배분이 일어나는 반면, OT 경로에서는 이동이 시간 전체에 고르게 분산됩니다. Lipman et al.(2023)은 같은 모델 용량에서 OT 경로가 더 빠른 학습과 더 적은 평가 횟수의 샘플링으로 이어짐을 실험적으로 확인했습니다.
10.2.4 주의: 조건부가 직선이어도 주변은 직선이 아니다
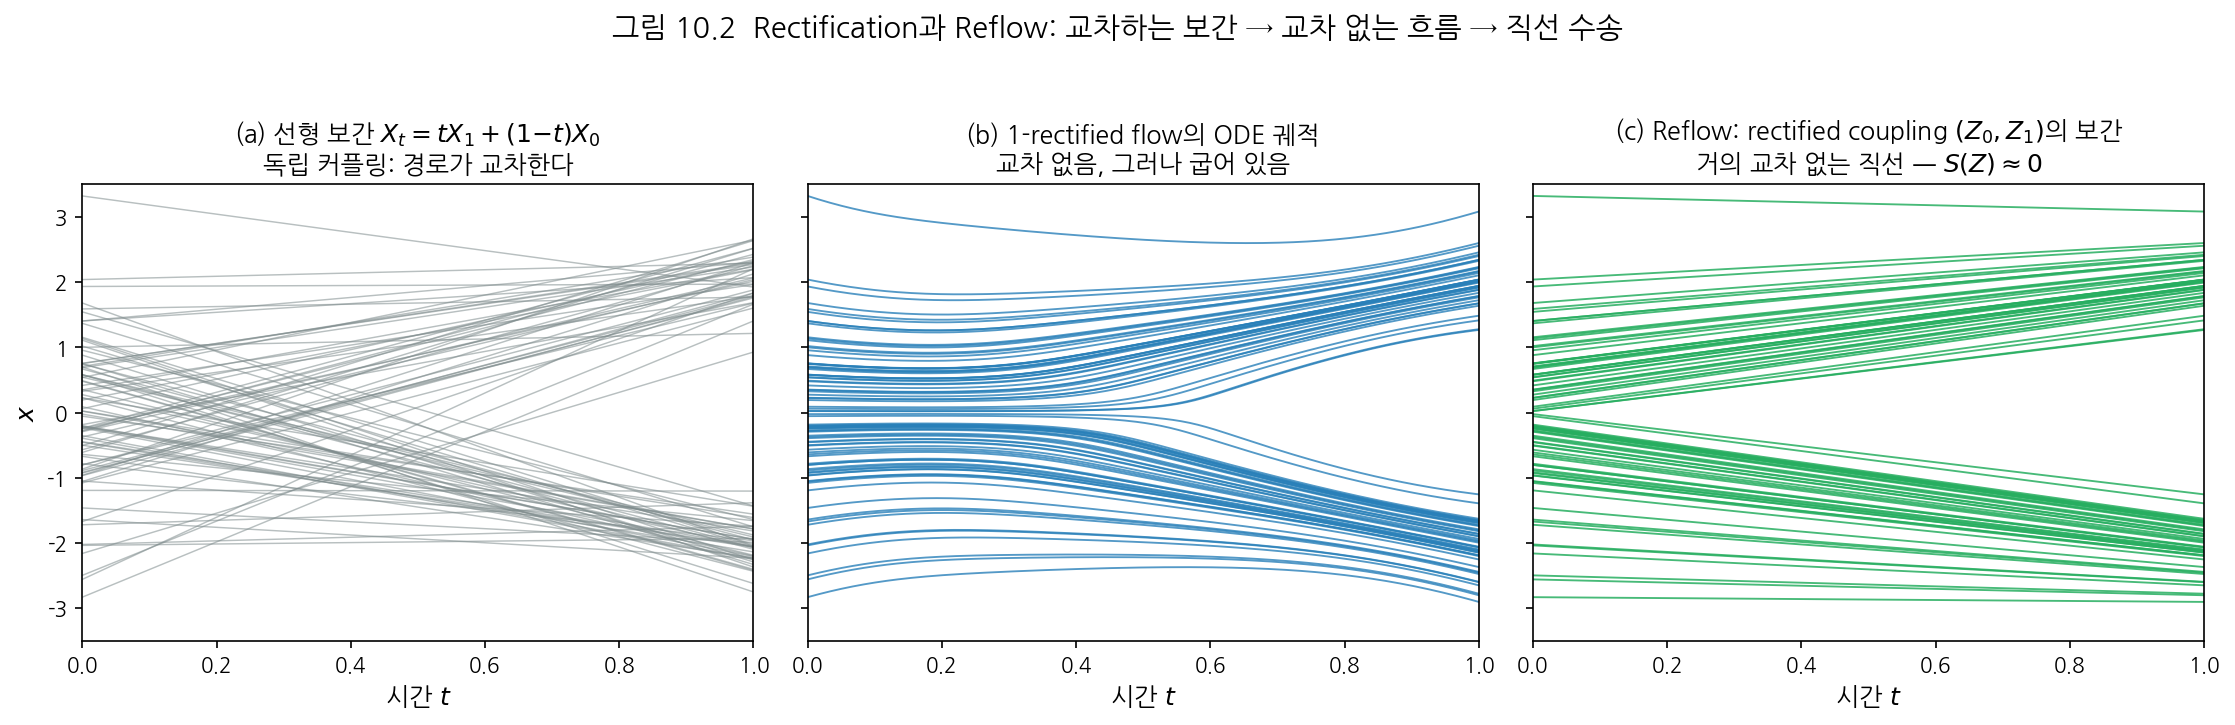
한 가지 흔한 오해를 바로잡고 넘어가겠습니다. OT 경로의 조건부 flow가 직선이라고 해서, 학습된 주변 속도장의 ODE 궤적까지 직선인 것은 아닙니다. 주변 속도장은 여러 데이터 점을 향하는 조건부 속도들의 가중 평균이므로, 서로 다른 방향의 조건부 경로들이 교차하는 영역에서는 평균된 속도가 시간에 따라 방향을 바꿉니다. 또한 위의 구성은 $x_0 \sim p_0$와 $x_1 \sim q$를 독립적으로 짝짓기 때문에 (9장의 언어로는 커플링이 곱측도 $p_0 \otimes q$이기 때문에) 두 분포 사이의 진짜 OT와는 거리가 있습니다. 독립 커플링 아래에서는 멀리 떨어진 노이즈와 데이터가 짝이 되는 일이 빈번하고, 그런 짝들을 잇는 직선들은 공간에서 어지럽게 교차합니다. 이 두 가지 관찰인 커플링을 개선해야 한다는 것과 주변 궤적 자체를 직선화해야 한다는 것이 각각 다음 두 절의 주제입니다.
10.3 OT-CFM: 커플링을 최적 수송에 가깝게
Tong et al.(2024)의 generalized Conditional Flow Matching은 위 구성의 숨은 자유도를 드러냅니다. 조건을 데이터 점 $x_1$ 하나가 아니라 쌍 $(x_0, x_1)$에 걸고, 그 쌍을 어떤 결합 분포 $\pi(x_0, x_1)$에서 뽑을지를 선택하는 것입니다. 조건부 경로는 두 점을 잇는 직선 보간으로 두고, 커플링 $\pi$만 바꿉니다. $\pi = p_0 \otimes q$ (독립 커플링)를 쓰면 10.2절의 기본 구성으로 되돌아가고, $\pi$를 9장의 최적 커플링 $\pi^*$로 쓰면 조건부 경로들이 정확히 displacement interpolation의 입자 궤적과 일치하게 됩니다. Tong et al.(2024)은 실제 OT 계획이 주어지는 경우 이 방법(OT-CFM)이 동역학적 OT를 근사함을 보였습니다.
물론 데이터 분포 전체에 대한 $\pi^*$를 구하는 것은 그 자체로 고차원 OT 문제이므로 불가능합니다. 실용적 타협은 미니배치 OT입니다. 학습의 매 반복에서 노이즈 미니배치와 데이터 미니배치 사이의 이산 OT 문제(9.3절의 선형 계획, 또는 9.7절의 Sinkhorn)를 풀어 배치 안에서의 최적 짝짓기를 찾고, 그 짝들로 CFM 손실을 계산합니다. 배치 단위의 OT는 전체 OT의 편향된 근사이지만, 독립 커플링보다 훨씬 덜 교차하는 경로를 만들며, 그 결과 더 곧은 주변 궤적과 더 적은 적분 step으로 이어집니다. 무엇보다 이 일반화는 출발 분포가 가우시안이어야 한다는 제약을 제거합니다. $p_0$가 임의의 분포, 심지어 밀도를 평가할 수 없는, 샘플만 있는 분포여도 무방하므로, 분포 대 분포 변환이라는 더 넓은 문제가 같은 틀에서 풀립니다.
10.4 Rectified Flow: 경로를 펴는 기계
10.4.1 가장 단순한 구성
Liu, Gong & Liu(2023)의 Rectified Flow는 Flow Matching과 독립적으로, 그러나 거의 동시에 제안된 같은 정신의 방법입니다. 구성은 더할 나위 없이 단순합니다. 임의의 커플링 $(X_0, X_1) \sim \pi$ 가장 간단하게는 독립 커플링에서 출발하여, 두 점을 잇는 선형 보간
$$ X_t = t\, X_1 + (1 - t)\, X_0, \qquad t \in [0, 1] $$
을 깔아 둡니다. 보간 입자의 속도는 상수 $\dot X_t = X_1 - X_0$이므로, 신경망에게 다음의 비선형 최소제곱 문제를 풀게 합니다.
$$ \min_\theta \int_0^1 \mathbb{E}_{(X_0, X_1) \sim \pi} \left\| (X_1 - X_0) - v_\theta(X_t, t) \right\|^2 dt $$
이는 $\sigma_{\min} \to 0$의 극한에서 10.2절의 OT 경로 CFM과 일치하며, "현재 위치 $X_t$를 지나는 보간선들의 평균 방향을 맞혀라"라는 회귀입니다. 최적해는 조건부 기댓값 $v^*(x, t) = \mathbb{E}[X_1 - X_0 \mid X_t = x]$입니다. 학습이 끝나면 ODE $\frac{dx}{dt} = v^*(x, t)$로 입자를 흘려보내는데, 이렇게 얻은 흐름을 rectified flow, 그 흐름이 만드는 새로운 끝점 쌍 $(Z_0, Z_1)$을 rectified coupling이라 부릅니다.
여기서 미묘하지만 중요한 점이 있습니다. 보간 경로 $X_t$들은 서로 교차할 수 있지만(서로 다른 짝을 잇는 직선들이 한 점을 지날 수 있으므로), ODE의 해 곡선들은 결코 교차할 수 없습니다(한 점에서의 속도는 유일하므로). 따라서 rectified flow의 궤적은 보간 직선들 그 자체가 아니라, 교차 지점에서 "통행자를 맞바꾸는" 방식으로 직선들을 이어 붙인, 교차 없는 경로망입니다. 그림 10.2의 왼쪽과 가운데 패널이 이 차이를 보여줍니다. 교차하던 직선 보간(왼쪽)이 rectification을 거치면 교차 없는, 그러나 약간 굽은 궤적(가운데)으로 재배선됩니다.
10.4.2 Rectification의 두 가지 보존 법칙
이 단순한 연산이 강력한 이유는 다음 두 성질 때문입니다(Liu et al., 2023).
첫째, 주변 분포가 보존됩니다. 최적 속도장이 조건부 기댓값이라는 사실과 연속 방정식을 결합하면, rectified flow가 운반하는 분포는 모든 시각 $t$에서 보간 입자 $X_t$의 분포와 정확히 일치함을 보일 수 있습니다. 특히 $Z_0 \sim \pi_0$이면 $Z_1 \sim \pi_1$입니다. 즉 rectification은 끝점 분포를 건드리지 않고 커플링만 바꾸는 연산입니다.
둘째, 수송 비용이 증가하지 않습니다. 임의의 볼록 비용 함수 $c$에 대해
$$ \mathbb{E}\big[ c(Z_1 - Z_0) \big] \;\le\; \mathbb{E}\big[ c(X_1 - X_0) \big] $$
이 성립합니다. 직관은 Jensen 부등식입니다. rectified flow의 변위는 교차 지점들에서 보간 방향들을 평균한 결과의 누적이고, 볼록 함수에서 "평균의 비용"은 "비용의 평균"을 넘지 못합니다. 9장의 언어로 번역하면, rectification은 모든 볼록 비용에 대해 동시에 커플링을 개선하는 연산입니다. 한 번의 rectification이 최적 커플링 $\pi^*$를 주지는 않지만, 나빠지는 일은 결코 없습니다.
10.4.3 Reflow: 반복하면 직선이 된다
주변 분포는 보존되고 커플링은 개선된다면, 같은 연산을 반복하지 못할 이유가 없습니다. 이것이 Reflow입니다. 학습된 rectified flow로 노이즈–데이터 쌍 $(Z_0, Z_1)$을 생성하고, 이번에는 이 쌍의 선형 보간으로 다시 rectification을 수행합니다. $k$번 반복한 흐름을 $k$-rectified flow라 부릅니다. 궤적이 얼마나 곧은지는 직선성(straightness) 범함수
$$ S(Z) = \int_0^1 \mathbb{E} \left\| (Z_1 - Z_0) - \dot Z_t \right\|^2 dt $$
로 측정하며, $S(Z) = 0$은 모든 궤적이 정확한 등속 직선임을 뜻합니다. Liu et al.(2023)은 reflow를 반복하면 직선성이 단조적으로 개선되어 $S \to 0$으로 수렴함을 보였습니다. 그림 10.2의 오른쪽 패널이 보여주듯, 한두 번의 reflow만으로도 궤적은 시각적으로 거의 완전한 직선이 됩니다.
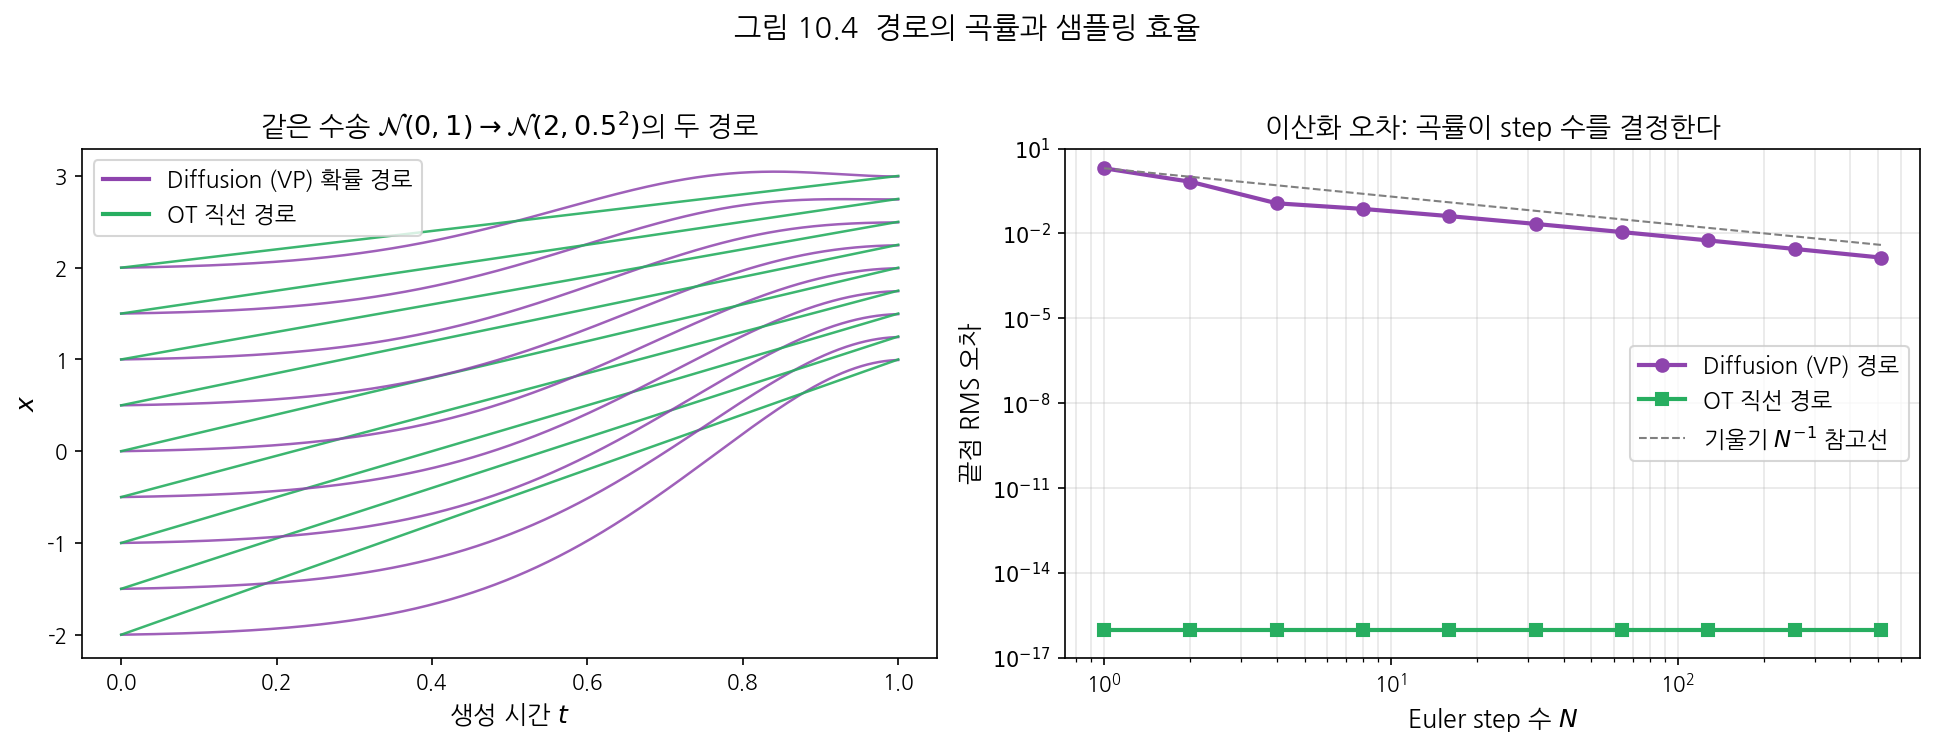
직선 궤적의 보상은 도입 인용구가 말한 그대로입니다. 속도가 상수인 궤적 위에서 Euler 한 step $x_1 = x_0 + v_\theta(x_0, 0)$은 이산화 오차가 정확히 0입니다. 즉 완전히 직선화된 flow는 신경망 평가 단 한 번으로 샘플을 생성합니다. 수백 step의 DDPM에서 출발한 여정이 한 step에 도달하는 이 극적인 압축의 대가는, reflow 단계마다 모델 자신이 생성한 쌍으로 재학습해야 하므로 근사 오차가 누적될 수 있다는 점입니다. 실무에서는 1~2회의 reflow 후 증류(distillation)를 결합하는 절충이 흔히 쓰입니다.
한 가지 이론적 단서를 달아 두겠습니다. Reflow의 고정점이 9장의 OT 최적 커플링과 일치한다는 보장은 일반적으로 없습니다. Rectification은 모든 볼록 비용을 동시에 줄이는 방향으로 움직일 뿐, 특정 비용($W_2$의 이차 비용)의 최솟값을 겨냥하지 않기 때문입니다. 그럼에도 "교차 없는 직선 수송"이라는 도달점은 Brenier 사상이 만드는 수송의 기하학적 특징과 정성적으로 같으며, 실용적 목적인 적은 step의 생성에는 그것으로 충분합니다.
10.4.4 산업 표준이 된 직선 경로: Stable Diffusion 3
이 이론이 대규모 실전에서 검증된 사례가 Esser et al.(2024)의 Stable Diffusion 3입니다. 이 연구는 고해상도 텍스트-이미지 합성에서 rectified flow 정식화를 기존 diffusion 정식화들과 대규모로 비교하여 일관된 우위를 확인했고, 학습 시 시각 $t$의 샘플링 분포를 지각적으로 중요한 중간 시간대에 집중시키는 개선을 더해 rectified flow를 채택했습니다. 이후 공개된 대형 이미지·영상 생성 모델의 상당수가 같은 정식화를 따르면서, "직선 경로 위의 속도장 회귀"는 사실상의 표준 학습 방식으로 자리 잡았습니다. 9장에서 출발한 기하학적 질문이 3년 만에 산업의 기본 설정이 된 셈입니다.
10.5 Schrödinger Bridge: 확률적 관점의 통합
10.5.1 1931년의 사고 실험
이제 이 장의 마지막 조각이자, OT와 Diffusion을 잇는 이론적 다리를 놓을 차례입니다. 출처는 뜻밖에도 양자역학의 아버지 중 한 사람입니다. Schrödinger(1931; 1932)는 다음과 같은 사고 실험을 제안했습니다. 브라운 운동을 하는 수많은 독립 입자들을 관찰하는데, 시각 $t=0$에 분포 $\mu$였던 입자들이 시각 $t=1$에 분포 $\nu$로 관측되었다고 합시다. 그런데 $\nu$가 브라운 운동의 법칙이 예측하는 분포와 다르다면, 즉 매우 드문 사건이 일어났다면 그 사이의 시간 동안 입자들은 가장 그럴듯하게는 어떤 경로를 지나갔겠는가?
이 질문의 현대적 정식화(Léonard, 2014)는 경로 공간 위의 상대 엔트로피 최소화입니다. $R$을 기준 과정(reference process), 예컨대 분산 $\varepsilon$의 브라운 운동의 경로 측도라 하고, 경로 측도 $P$ 중에서 양 끝 주변 분포가 관측과 일치하는 것들만 놓고 기준 과정에 가장 가까운 것을 찾습니다.
$$ P^* = \underset{P:\; P_0 = \mu,\; P_1 = \nu}{\arg\min}\; \mathrm{KL}(P \,\|\, R) $$
이 문제를 Schrödinger Bridge(SB) 문제, 그 해를 두 분포 사이에 걸린 "다리"라 부릅니다. 대편차 이론의 관점에서 $P^*$는 조건부로 가장 일어나기 쉬운 입자 집단의 거동이며, 확률 제어의 관점에서는 기준 동역학에 최소한의 제어(drift)를 더해 $\mu$를 정확히 $\nu$로 보내는 문제입니다.
10.5.2 SB는 entropic OT다
SB 문제는 동적(경로 공간) 문제이지만, 끝점만 바라보는 정적 문제로 환원됩니다. 경로 측도의 KL을 끝점 결합 분포의 KL과 끝점이 고정된 다리 내부의 KL로 분해하면, 내부 항은 기준 과정의 브라운 다리로 맞춰 0으로 만들 수 있으므로, 남는 것은 끝점 커플링에 대한 최적화뿐입니다. 기준 과정이 분산 $\varepsilon$의 브라운 운동일 때 그 결과는
$$ \pi^*_{\mathrm{SB}} = \underset{\pi \in \Pi(\mu, \nu)}{\arg\min}\; \int \frac{\|x - y\|^2}{2\varepsilon}\, d\pi(x, y) \;+\; \mathrm{KL}\big(\pi \,\|\, \mu \otimes \nu\big) $$
입니다. 이 식을 9.7절과 나란히 놓아 보십시오. 이것은 정확히 entropic regularization을 더한 Kantorovich 문제, 즉 Sinkhorn 알고리즘이 푸는 바로 그 문제입니다. 9장에서 "계산을 위한 편법"처럼 소개되었던 엔트로피 항이, 사실은 1931년 슈뢰딩거의 물리적 질문에 내재해 있던 구조였던 것입니다. 두 극한이 이 동치를 완성합니다. $\varepsilon \to 0$이면 엔트로피 항이 무시되어 SB는 결정론적 OT(Brenier 사상과 displacement interpolation)로 수렴하고, $\varepsilon$이 커질수록 다리는 확률적으로 넓게 퍼집니다. OT는 노이즈 0의 SB이고, SB는 노이즈 있는 OT입니다.
10.5.3 SB와 Diffusion: 유한 시간의 정확한 다리
이제 Diffusion과의 관계를 명확히 할 수 있습니다. De Bortoli et al.(2021)의 관찰을 따라가 봅시다. Score 기반 생성 모델(7장)은 forward SDE가 데이터를 가우시안 "근처"로 보내는 것에 의존하며, 그 근사는 $T$가 충분히 클 때만 좋아집니다. 반면 SB 문제에서 $\mu = p_{\mathrm{data}}$, $\nu = \mathcal{N}(0, I)$, 기준 과정 $R$을 diffusion의 forward SDE로 두면, 그 해는 유한한 시간 안에 데이터 분포를 정확히 가우시안으로, 그리고 거꾸로 가우시안을 정확히 데이터 분포로 보내는 과정이 됩니다. 즉 SB는 Diffusion이 점근적으로만 달성하는 것을 유한 시간에 정확히 달성하는, Diffusion의 원리적 완성형입니다. 거칠게 말해 Diffusion 생성 모델은 이 SB 문제의 1회 근사, orward는 기준 과정 그대로 두고 reverse만 학습하는 반쪽 반복에 해당합니다.
SB의 해는 고전적 결과에 의해 아름다운 구조를 가집니다. 최적 과정의 forward 표현은 기준 SDE에 보정 drift를 더한
$$ dx = \big[ f(x, t) + g(t)^2\, \nabla_x \log \Psi_t(x) \big]\, dt + g(t)\, dw $$
의 형태이며, 여기서 $\Psi_t$는 짝이 되는 함수 $\hat\Psi_t$와 함께 끝점 조건으로 연립된 Schrödinger 시스템을 만족하고, 주변 밀도는 $p_t = \Psi_t\, \hat\Psi_t$로 인수분해됩니다. 7장의 Reverse SDE에서 Score $\nabla \log p_t$가 하던 역할을, SB에서는 이 포텐셜 쌍의 로그 그래디언트가 나누어 맡는 셈입니다. 문제는 $\Psi, \hat\Psi$를 직접 구할 수 없다는 것인데, De Bortoli et al.(2021)의 Diffusion Schrödinger Bridge(DSB)는 9.7절 Sinkhorn의 연속 시간 일반화인 Iterative Proportional Fitting(IPF)으로 이를 우회합니다. forward 과정을 고정하고 끝점 조건을 맞추는 backward 과정을 score 기반 기법으로 학습하고, 다시 그 backward를 고정하고 forward를 학습하는 교대 반복으로, 매 반복이 한쪽 끝점 제약의 사영(projection)에 해당하며 SB 해로 수렴합니다. Sinkhorn의 행/열 정규화 교대가 경로 공간으로 올라간 것입니다.
10.6 왜 적은 step으로 생성할 수 있는가: 정량적 정리
이 장의 제목이 약속한 질문인 왜 Flow Matching 계열은 적은 step으로 생성할 수 있는가에 이제 정량적으로 답할 수 있습니다. 결정론적 샘플링은 결국 ODE의 수치 적분이고, step 수 $N$의 Euler 방법이 갖는 전역 오차는 궤적의 곡률에 비례합니다. 구체적으로, 궤적 $x(t)$를 따라가는 Euler 적분의 국소 절단 오차는 $\frac{1}{2}\|\ddot x(t)\|\, (\Delta t)^2$ 차수이므로, 전역 오차는 대략
$$ \text{전역 오차} \;\lesssim\; \frac{1}{2N}\, \max_{t} \|\ddot x(t)\| \;+\; \mathcal{O}(N^{-2}) $$
입니다. 분자의 $\|\ddot x\|$, 즉 궤적이 굽은 정도가 모든 것을 결정합니다. Diffusion의 PF-ODE 궤적은 $\|\ddot x\|$가 크므로(특히 노이즈 스케줄이 급변하는 구간에서) 오차를 누르려면 $N$을 키우는 수밖에 없습니다. 반면 직선화된 flow는 $\ddot x \approx 0$이므로 $N$이 작아도, 극한에서는 $N = 1$이어도 오차가 발생하지 않습니다. 직선성 범함수 $S(Z)$가 0이라는 것은 정확히 모든 궤적에서 $\ddot Z_t = 0$이라는 뜻이므로, Reflow는 Euler 오차의 상수를 직접 공격하는 알고리즘이라고 읽을 수 있습니다. 그림 10.4는 같은 1차원 가우시안 수송 문제에서 Diffusion 경로와 직선 경로의 Euler 적분 오차가 step 수에 따라 어떻게 갈라지는지를 보여줍니다.
마지막으로 이 장에서 등장한 방법들을 시리즈 전체의 좌표계 위에 정리합니다.
| 관점 | 학습 대상 | 경로의 성격 | 전형적 step 수 |
|---|---|---|---|
| DDPM (4–5장) | 노이즈 $\epsilon_\theta$ | forward 과정이 결정하는 확률적 곡선 경로 | 수백~천 |
| Score SDE / PF-ODE (6–7장) | Score $s_\theta = \nabla \log p_t$ | 같은 경로의 연속 시간 표현; ODE는 결정론적이나 굽음 | 수십~수백 |
| Flow Matching / OT-CFM (10.2–10.3절) | 속도장 $v_\theta$ | 설계된 경로(가우시안 측지선 등); 커플링 개선 가능 | 수~수십 |
| Rectified Flow + Reflow (10.4절) | 속도장 $v_\theta$ (반복 재학습) | 반복 직선화로 $S(Z) \to 0$ | 1~수 |
| Schrödinger Bridge / DSB (10.5절) | forward/backward drift 쌍 (IPF) | 유한 시간 정확 수송; $\varepsilon \to 0$에서 OT로 수렴 | 수십 (정확한 끝점) |
10.7 요약 및 다음 장 예고
이번 장에서 우리는 9장의 기하학을 생성 모델의 설계 원리로 전환했습니다.
Diffusion의 굽은 경로와 많은 샘플링 step은 본질이 아니라 노이즈 주입이라는 경로 선택의 결과였습니다. Flow Matching은 확률 경로를 직접 설계하고 그것을 생성하는 속도장을 회귀하는 틀을 제공하되, 계산 불가능한 주변 속도장 대신 데이터 점에 조건을 건 조건부 속도장을 회귀해도 그래디언트가 일치한다는 Conditional Flow Matching 정리로 시뮬레이션 없는 학습을 완성했습니다. 가우시안 조건부 경로의 틀 안에서 Diffusion은 하나의 스케줄 선택에 불과하며, displacement interpolation에서 영감을 받은 직선 조건부 경로가 더 효율적인 대안임을 보았습니다. Tong et al.의 OT-CFM은 노이즈와 데이터의 커플링 자체를 미니배치 OT로 개선하여 구성을 진짜 동역학적 OT에 가깝게 만들었고, Rectified Flow는 선형 보간 회귀와 reflow의 반복으로 주변 분포를 보존하고 모든 볼록 수송 비용을 단조 감소시키면서 궤적의 직선성을 $S(Z) \to 0$까지 끌어올려 한 자릿수 step의 생성을 실현했으며, Stable Diffusion 3를 통해 산업 표준이 되었습니다. 마지막으로 Schrödinger Bridge는 이 모든 것을 하나로 묶었습니다. 경로 공간의 상대 엔트로피 최소화로 정의되는 SB는 정적으로는 9장의 entropic OT와 동치이고, $\varepsilon \to 0$에서 OT의 직선 수송으로 수렴하며, 기준 과정을 forward diffusion으로 두면 Diffusion이 점근적으로만 이루는 가우시안 도달을 유한 시간에 정확히 이루는 완성형이 됩니다. Euler 오차가 궤적의 곡률에 비례한다는 수치해석적 사실은 "직선 경로 = 적은 step"이라는 이 장의 표어에 정량적 근거를 제공했습니다.
참고문헌
- Chen, R. T. Q., Rubanova, Y., Bettencourt, J., & Duvenaud, D. (2018). Neural Ordinary Differential Equations. Advances in Neural Information Processing Systems, 31, 6572-6583. arXiv:1806.07366
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., & Le, M. (2023). Flow Matching for Generative Modeling. International Conference on Learning Representations. arXiv:2210.02747
- Liu, X., Gong, C., & Liu, Q. (2023). Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow. International Conference on Learning Representations (Spotlight). arXiv:2209.03003
- Tong, A., Fatras, K., Malkin, N., Huguet, G., Zhang, Y., Rector-Brooks, J., Wolf, G., & Bengio, Y. (2024). Improving and Generalizing Flow-Based Generative Models with Minibatch Optimal Transport. Transactions on Machine Learning Research. arXiv:2302.00482
- Albergo, M. S., & Vanden-Eijnden, E. (2023). Building Normalizing Flows with Stochastic Interpolants. International Conference on Learning Representations.
- Schrödinger, E. (1931). Über die Umkehrung der Naturgesetze. Sitzungsberichte der Preussischen Akademie der Wissenschaften, Physikalisch-mathematische Klasse, 144-153.
- Schrödinger, E. (1932). Sur la théorie relativiste de l'électron et l'interprétation de la mécanique quantique. Annales de l'Institut Henri Poincaré, 2(4), 269-310.
- Léonard, C. (2014). A Survey of the Schrödinger Problem and Some of Its Connections with Optimal Transport. Discrete and Continuous Dynamical Systems - Series A, 34(4), 1533-1574.
- De Bortoli, V., Thornton, J., Heng, J., & Doucet, A. (2021). Diffusion Schrödinger Bridge with Applications to Score-Based Generative Modeling. Advances in Neural Information Processing Systems, 34, 17695-17709. arXiv:2106.01357
- Esser, P., Kulal, S., Blattmann, A., Entezari, R., Müller, J., Saini, H., Levi, Y., Lorenz, D., Sauer, A., Boesel, F., Podell, D., Dockhorn, T., English, Z., Lacey, K., Goodwin, A., Marek, Y., & Rombach, R. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis. Proceedings of the 41st International Conference on Machine Learning (Oral). arXiv:2403.03206
'인공지능 논문 정리 > Diffusiion' 카테고리의 다른 글
| [Diffusion 11]. Diffusion의 통합적 이해: VAE, Normalizing Flow, 그리고 Score-based Model (1) | 2026.06.13 |
|---|---|
| [Diffusion 9] Optimal Transport 입문: Wasserstein 거리와 최적 경로 (0) | 2026.06.12 |
| [Diffusion 8] Guidance의 수학: 조건부 생성을 가능케 하는 원리 (0) | 2026.06.11 |
| [Diffusion 7] 연속 시간으로의 확장: SDE와 ODE 관점에서 본 Diffusion (0) | 2026.06.07 |
| [Diffusion 6] Score Function이란 무엇인가: Score Matching에 대한 이해 (2) | 2026.01.20 |


